

最近 Agent 圈有一个很值得关注的变化:
大家开始意识到,并不是所有问题都需要交给大语言模型“思考”。
一个 Agent 收到任务后,往往首先需要回答的其实是:
这个任务属于什么类型?
应该交给哪个 Agent?
应该调用哪个 Tool?
是否需要联网?
是否需要人工确认?
当前风险等级是多少?
多条执行路径应该走哪一条?
这些问题本质上并不是“生成问题”,而是:
决策问题。
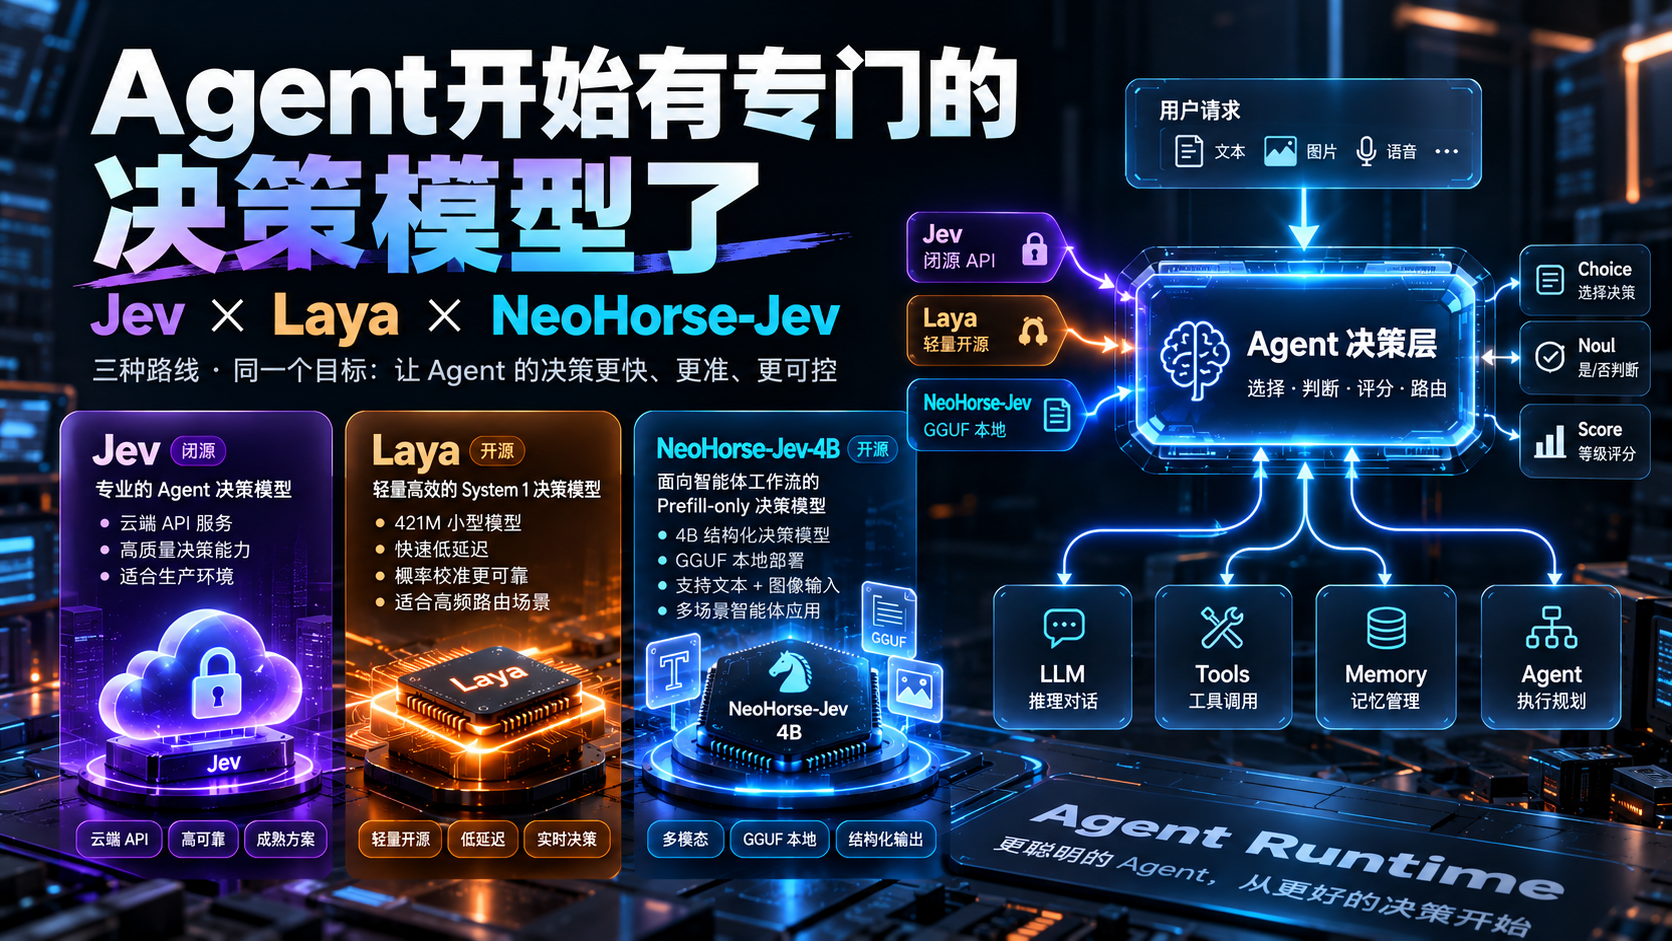
于是,一类和传统 LLM 很不一样的模型开始进入 Agent 架构: Decision Model,决策模型。 目前比较有代表性的三条路线,分别是: Jev、Laya,以及最近出现的 NeoHorse-Jev-4B。
一、为什么 Agent 需要独立的“决策层”?
传统 Agent 很容易做成这样:
用户请求
   ↓
LLM
   ↓
分析任务
   ↓
选择 Agent
   ↓
选择工具
   ↓
调用工具
   ↓
LLM继续分析
   ↓
生成结果
这里有一个问题:几乎所有工作都让 LLM 做了。 例如用户只是说:帮我查一下这个订单什么时候发货。 Agent 可能只是需要判断:
任务类型 = 订单查询
需要工具 = Order API
风险等级 = Low
结果我们却让一个几十亿甚至几百亿参数的生成模型读取 Prompt、Tool Schema,再输出一段结构化内容。 能做。但不一定划算。 这就像请一个高级架构师每天负责判断:“这封邮件应该转给财务还是技术部?” 明显有点“大模型打小工”。 于是 Jev 这类模型提出了另一种思路:
State
  ↓
Decision Model
  ↓
结构化决策
不生成文章。不聊天。甚至不需要输出自然语言。 只负责:下一步该干什么。
二、Jev:把 System 1 决策模型带进 Agent
Jev 是 TypeSafe AI 推出的决策模型。它和 ChatGPT、Claude、Qwen 这一类生成模型最大的不同在于: Jev 的主要输出不是文本,而是决策。 目前它的核心接口围绕三种 primitive 展开:
Choice
从几个候选项中选择一个,并给出各候选项的概率。例如:
应该调用哪个 Agent?
research
coding
data
general
返回:
research  0.86
coding    0.07
data      0.04
general   0.03
Noul
判断一个条件是否成立。本质上返回:
P(true)例如:
这个任务是否需要联网?可能得到:
0.94然后程序自己写:
if probability > 0.8:
    enable_web_search()
Score
在一组有序等级中进行评分。例如风险:
低
中
高
严重
模型不仅可以选择等级,还可以输出等级概率分布与对应 Score。Jev 官方服务采用 System One API 的形式提供这些结构化判断,而不是传统 Chat Completion。公开资料显示,其模型和训练方法属于 proprietary 路线,主要通过托管 API 使用,并没有公开可供用户自行部署的完整模型权重。 这也是 Jev 最大的特点之一。它证明了一件事情: Agent 不一定需要让 LLM 完成所有决策。
三、但 Jev 有一个现实问题:它是闭源路线
如果只是 SaaS 或在线 Agent,API 并不是什么大问题。但一旦进入:
私有化部署
企业内网
本地 Agent
边缘设备
数据敏感业务
高并发 Router
问题就来了。假设每一次任务都要先:
Agent
  ↓
互联网
  ↓
Jev API
  ↓
Decision
那么系统就必须考虑:
API成本
网络延迟
服务可用性
数据外发
版本变化
厂商依赖
更关键的是:你没有模型本身。 这也是为什么 Jev 出现以后,很快有人开始尝试: 能不能做一个可以本地运行的 System 1 决策模型? 于是 Laya 出现了。
四、Laya:421M的小型开源System 1
Laya 是 Convai Innovations 发布的开源权重 System 1 Decision Model。 基础版本参数规模只有:421M。不是 4B。也不是 40B。而是:
0.421B它基于 ModernBERT-large,并采用非自回归方式完成决策。公开模型说明将其定位为可以输入文本、邮件、Ticket 或 JSON State,然后直接输出结构化决策的模型。 它同样支持类似的:
Choice
Score
Noul
工作方式。 因此从 Agent 架构看:
Jev
 ↓
Choice / Score / Noul

Laya
 ↓
Choice / Score / Noul
二者解决的问题高度相似。但部署路线完全不同。
五、Laya最大的优势其实不是“能力最强”
而是:够小。 421M 对今天的 AI 模型来说已经属于非常轻量的级别。Laya 官方模型卡给出的典型推理描述约为: ~33ms 单次 Forward Pass 当然,真实延迟仍然与 GPU、Batch、输入长度以及运行环境有关,不能把这个数字理解成所有机器都固定 33ms。 但是这个设计方向很重要。 因为 Agent Router 可能不是每天运行几十次。而可能是:
一次Agent任务
   ↓
任务分类
   ↓
模型选择
   ↓
Tool选择
   ↓
风险判断
   ↓
结果检查
一次任务内部就触发很多次决策。如果这是一个高并发 Agent Server:
1000次任务
×
5次决策
=
5000次Decision六、Laya还有一个很有意思的设计:概率校准
普通分类模型可能告诉你:
A:0.95
B:0.04
C:0.01
但这个 0.95 到底是不是“真的约等于95%可信”?不一定。 Laya 特别强调: Calibrated Probability。 其模型说明称训练中采用 RLCD,并使用 proper scoring rules 来鼓励模型输出更真实的概率。 这对 Agent 特别重要。 因为 Agent 不一定要:
永远相信模型而可以:
if confidence > 0.9:
    execute()

elif confidence > 0.7:
    ask_llm()

else:
    human_review()
于是整个 Agent 可以出现一种非常漂亮的架构:
Laya
 │
 ├── 高置信度 → 直接执行
 │
 ├── 中置信度 → LLM进一步判断
 │
 └── 低置信度 → 人工确认
这才是概率真正有工程价值的地方。
七、然后NeoHorse-Jev-4B出现了
如果说:
Jev证明了“Decision Model 这条路线是成立的”。而:
Laya证明了“小型开源 Decision Model 可以本地跑”。
NeoHorse-Jev-4B 由 TokenRhythm 基于:
NeoHorse-1-4B构建。参数规模约:4B。 模型采用:Prefill-only inference 同样支持:
Choice
Noul
Score
并且不是自回归生成文本,而是直接预测调用方定义的答案和概率。
八、NeoHorse-Jev和Laya虽然像,但其实路线不同
从表面看:
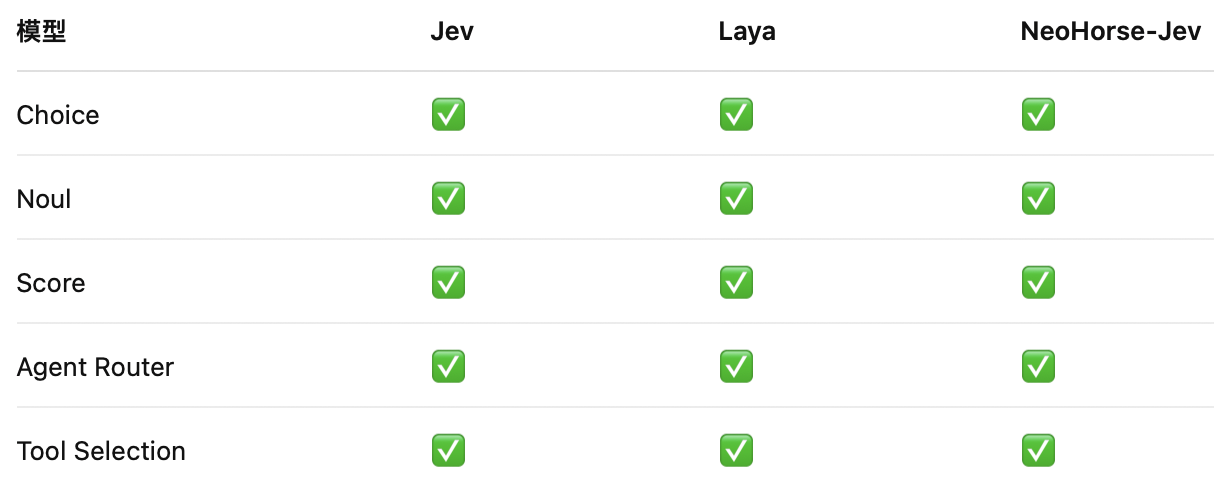
似乎都是一回事。实际上差异非常明显。最直接的就是模型规模。
Laya
421M
NeoHorse-Jev
≈4B
差不多接近一个数量级。Laya 更接近:
极轻量专用 Decision Encoder。
NeoHorse-Jev 则更加接近:
拥有较强语言理解 Backbone 的 Decision Model。
所以它们未来很可能不是完全替代关系。而是部署位置不同。
九、还有一个巨大区别:NeoHorse-Jev支持视觉
NeoHorse-Jev-4B 不只是:
Text → Decision还支持:
Image + Text
      ↓
Decision十、GGUF版本又让它往本地Agent迈了一步
这次 NeoHorse-Jev-4B-GGUF 提供了:
BF16
Q8_0
Q4_K_M
Q3_K_M
Q2_K
五个版本。其中很值得注意的是:
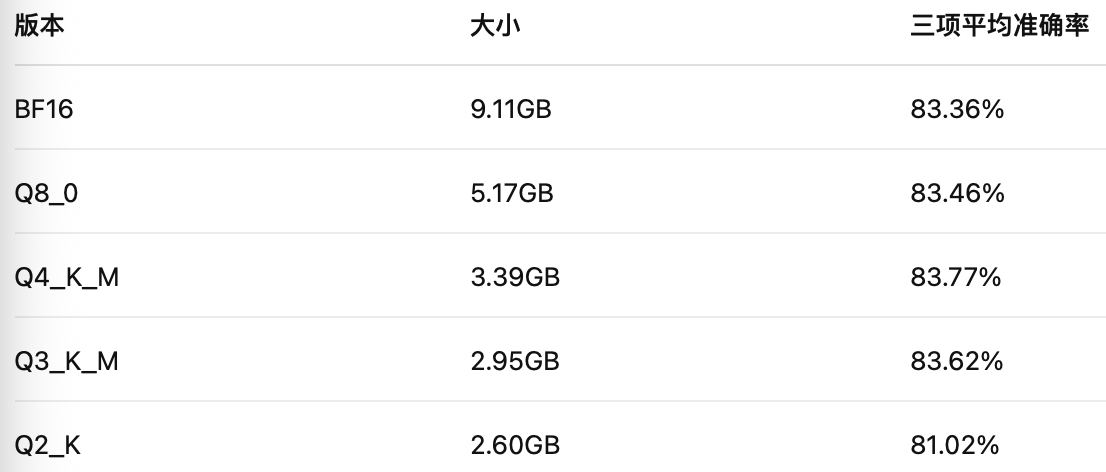
这里最值得注意的是:Q4_K_M。 文件只有:
3.39GB而这组量化实验里的 AVG 为:
83.77%因此,如果准备实际体验 NeoHorse-Jev:
Q4_K_M 是非常合理的第一选择。
需要注意的是,量化结果中的小幅反超并不能简单解释为“4bit 比 BF16 更聪明”。这种差距可能受到:
数据规模
数值扰动
Benchmark波动
等因素影响。更合理的结论应该是:
Q4_K_M 在这组测试中基本保持了原模型的决策能力。
这才是它真正有价值的地方。
十一、那三者到底应该怎么理解?
可以把它们放进同一张表。
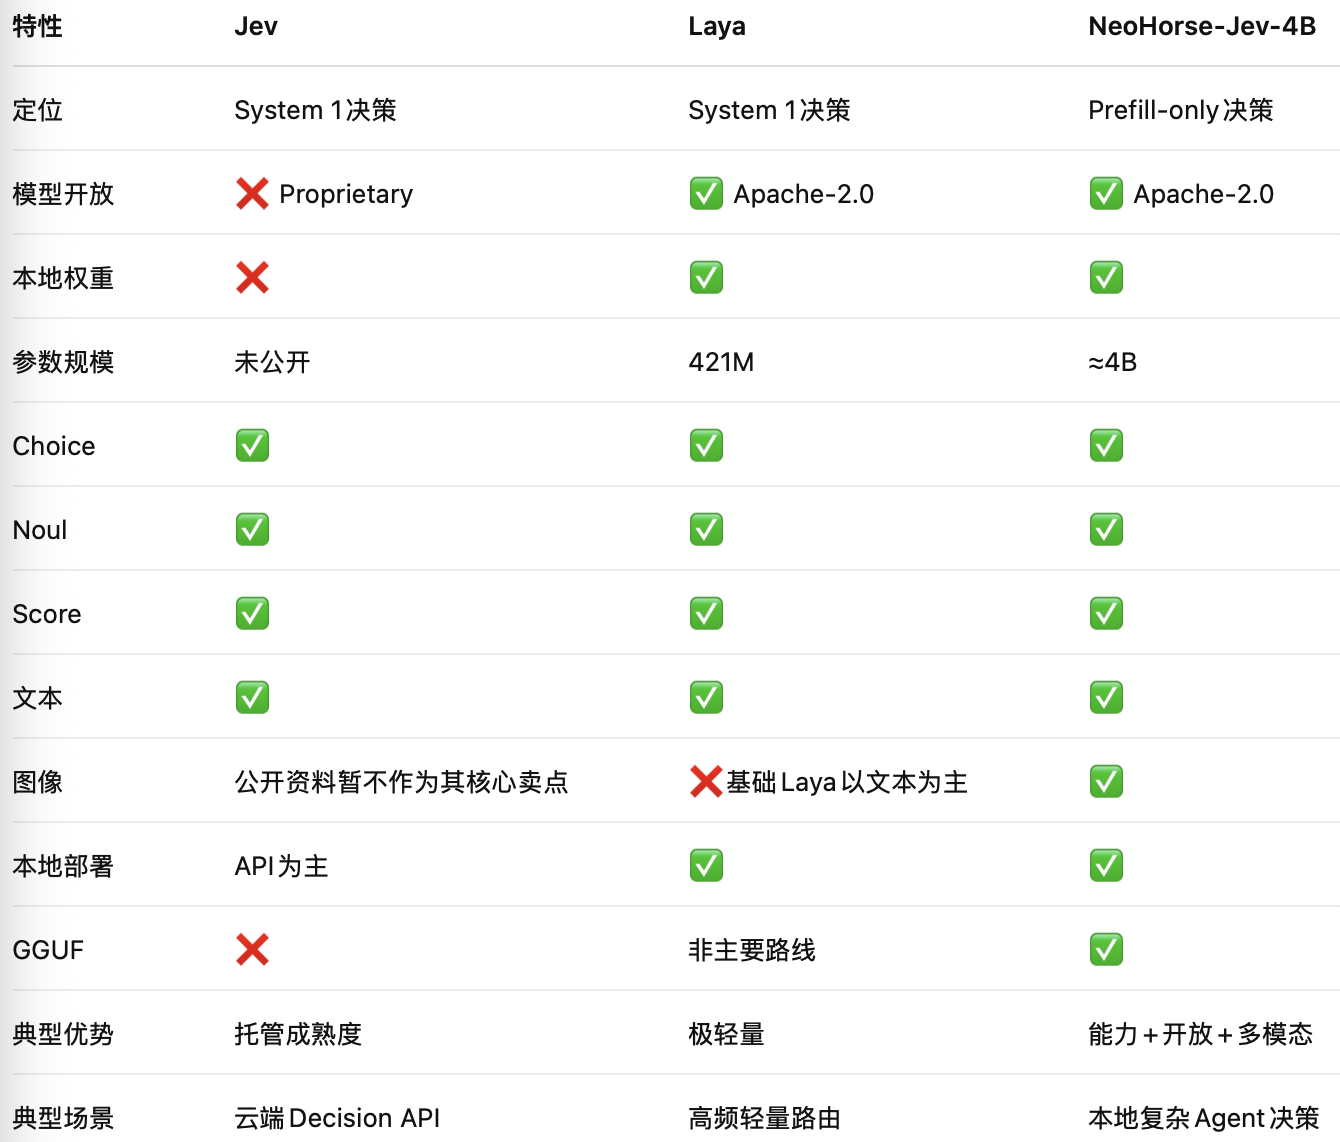
这里尤其需要强调:不要单纯按照参数大小判断谁更好。 它们服务的是不同工程约束。
十二、那谁的“能力更强”?
这是目前最容易被误解的地方。Laya 发布了一个:
laya-typed-decisions专门针对:
Agent Trace
Customer Service
Invoice Processing
Security Incidents
进行微调。该模型卡公开的一组 400 个测试 Case、2000 个 Decision 的结果是:
Laya Typed Decisions:0.766
TypeSafe Jev 1.13.0:0.727
也就是表面上:Laya高约3.9个百分点。 但模型作者自己也明确提醒:
Jev 的数字来自第三方公开结果,并非在同一项目中重新调用 Jev 测得,而且样本与 Prompt 存在差异。
所以这个结果只能视为:Indicative,而不是严格 Head-to-Head。 这个区别非常重要。
十三、NeoHorse-Jev也给出了自己的评测
NeoHorse-Jev-4B 官方模型卡报告: 在六组文本 Decision Benchmark 综合结果中:
77.70并称在其有完整结果的四个 Open-weight Decision Model 中最高。在:
Nimble
VitaminC
MASSIVE
三项中,原始 NeoHorse-Jev-4B 平均准确率达到:
83.26%而你前面看到的 GGUF Q4_K_M 量化结果则约为:
83.77%两者对应的模型实现和评测轮次需要区分。 所以目前更科学的判断不是: NeoHorse赢了Laya。 或者:Laya赢了Jev。 而应该是:Decision Model 已经开始形成一个独立的模型赛道。 而且不同模型开始针对不同工作流和部署环境进行优化。
十四、如果真正做Agent,我反而不会三选一
这是我认为最有意思的地方。很多人看到新模型以后首先会问: Jev、Laya、NeoHorse,到底用哪个? 但真正复杂的 Agent 系统,答案可能是: 全部可以有自己的位置。例如:
                User Request
                     │
                     ▼
              ┌────────────┐
              │    Laya    │
              │ Fast Router│
              └─────┬──────┘
                    │
        ┌───────────┼───────────┐
        ↓           ↓           ↓
      简单任务    不确定任务    高风险
        │           │
        ↓           ↓
   直接执行   NeoHorse-Jev
                    │
                    ↓
              Complex Decision
                    │
                    ↓
                   LLM
                    │
                    ↓
                  Tools
这时候:Laya 负责:
高频
低成本
低延迟
初步路由
NeoHorse-Jev 负责:
复杂语义判断
视觉状态判断
更困难的Tool Selection
多模态Decision
LLM 只负责:
Planning
Reasoning
Coding
Research
Generation
这样系统的成本结构就完全不一样了。
十五、这可能才是Agent未来真正的模型架构
过去我们做 Agent:
一个LLM
+
很多Tools
以后可能逐渐变成:
                Agent
                  │
     ┌────────────┼─────────────┐
     ↓            ↓             ↓
 Decision      Reasoning      Memory
 Model          Model          Model
     │            │
     ↓            ↓
  Router       Planner
     │
     ↓
   Tools
甚至进一步:
Request
   ↓
System 1
   ↓
Task Router
   ↓
Model Router
   ↓
Tool Router
   ↓
System 2
   ↓
Execution
   ↓
Verifier
这就已经不是:“给LLM接几个工具。” 而是在构建:真正的Agent Runtime。
十六、Laya最适合什么?
如果目标是:
本地部署
CPU/GPU资源有限
高频Decision
文本任务
低延迟Router
Laya依然非常有吸引力。 421M意味着它天然适合放在:Agent最前面的System 1层。 例如:
Task Type
Tool Required?
Risk Level
Route
Model Selection
这也是我认为 Laya 最有价值的位置。
十七、NeoHorse-Jev更适合什么?
NeoHorse-Jev-4B 更适合:
复杂语义
更多候选动作
视觉输入
本地私有部署
复杂Tool Selection
Agent Action Decision
尤其现在有 GGUF 以后:
Q4_K_M ≈ 3.39GB已经进入很多本地 AI 工作站可以接受的范围。它并不一定取代 Laya。更可能是:
成为System 1里面更重的一档决策模型。
十八、Jev还有没有价值?
当然有。闭源不等于没有价值。Jev最大的优势反而是: 开发者不需要维护模型。 调用:
API得到:
Choice
Noul
Score
即可。如果你的业务:
本来就在云端
数据允许外发
不想维护推理基础设施
更关注产品开发速度
那么 SaaS Decision API 本身就是非常合理的方案。而且 Jev 对这个领域最大的贡献可能并不仅仅是一个模型。而是:
让越来越多开发者意识到“Decision”本身值得拥有独立模型。
十九、真正值得关注的不是Jev、Laya还是NeoHorse
而是一个更大的变化:过去 Agent 的“大脑”几乎只有:
LLM现在正在慢慢变成:
Embedding Model
      +
Reranker
      +
Decision Model
      +
Reasoning Model
      +
Vision Model
      +
Memory
      +
Tools
每一种模型干自己最擅长的事情。于是:模型不再越大越好。 真正的问题变成:在正确的位置,应该调用哪个模型? 甚至未来 Agent 本身也需要一个:AI Asset Router。 根据任务动态选择:
模型
Skill
MCP
Tool
成本等级
执行路径
失败回退
这样来看,Jev、Laya、NeoHorse-Jev 的意义就不仅仅是三个新模型。它们背后实际上指向同一个趋势:
Agent正在从“一个大模型包打天下”,走向专业模型协同。
而 System 1 Decision Model,很可能会成为这个架构里越来越重要的一层。 LLM负责:想。 Tool负责:做。 Decision Model负责:决定下一步让谁来想、让谁来做。 这可能才是 Agent 真正开始工程化的标志。 这里我特意没有下“谁吊打谁”这种结论,因为 Jev、Laya Typed-Decisions、NeoHorse-Jev 当前公开 Benchmark 并非完全统一测试集、统一 Prompt、统一 Harness;直接拿准确率横向排第一第二并不严谨。NeoHorse 官方目前能比较确定的是其开放权重、约 4B、Apache-2.0、Choice/Noul/Score、Prefill-only 以及文本+单图输入这些能力;Laya 则在轻量级 421M、本地部署和概率校准上形成了非常鲜明的路线。