

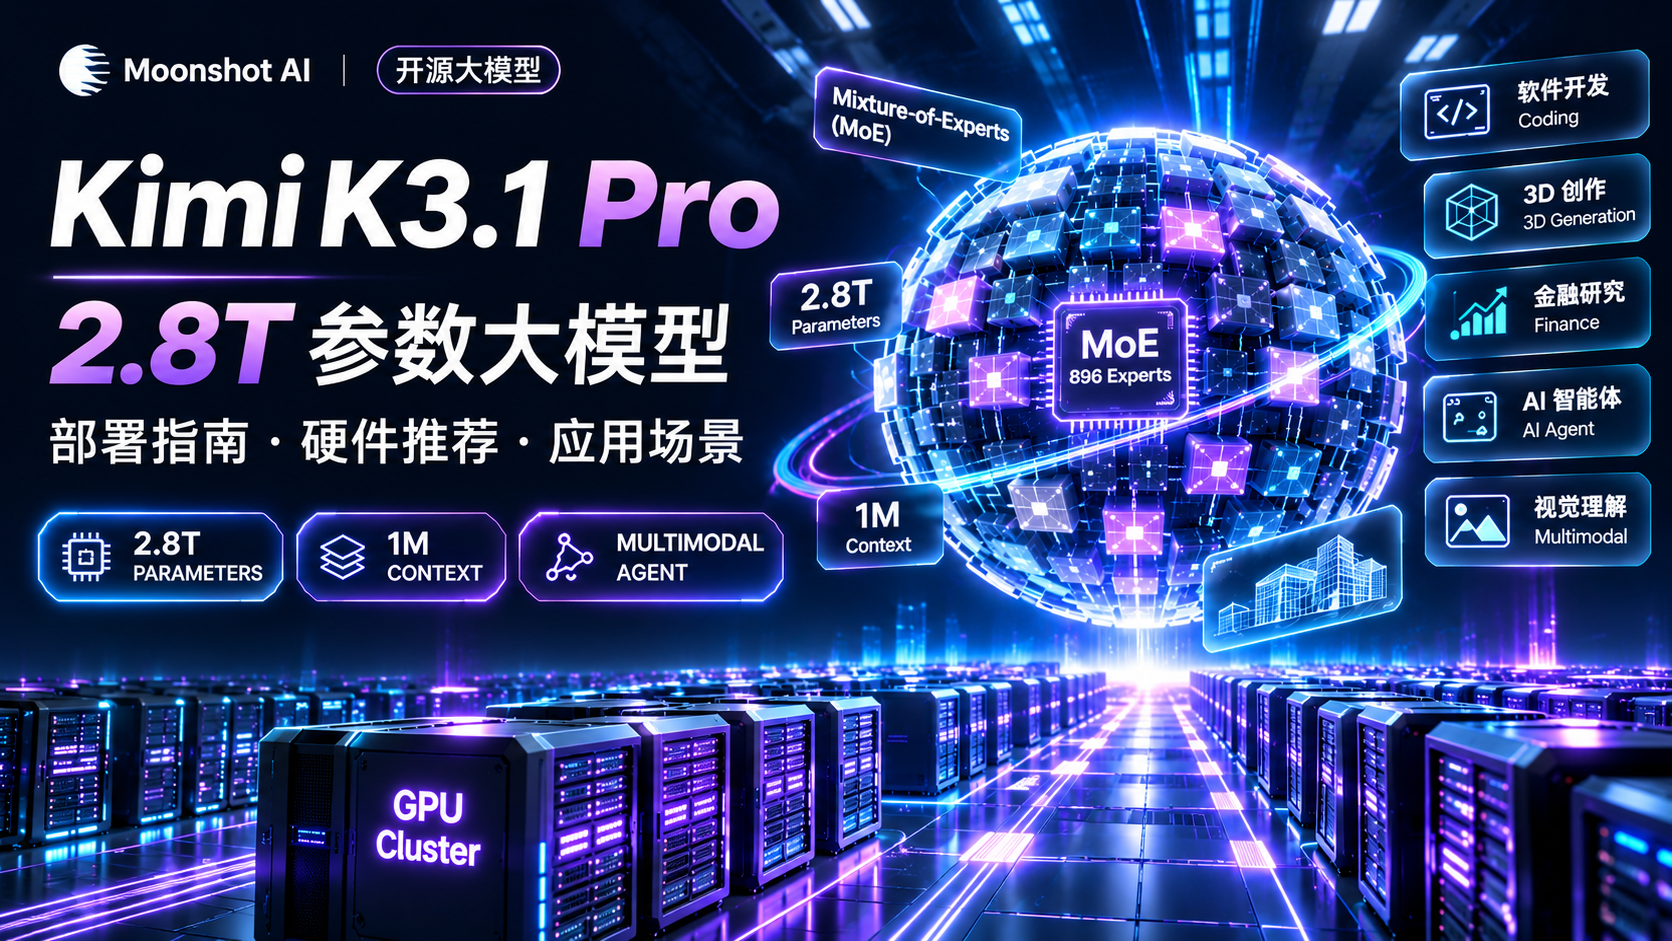
2026 年 11 月,Moonshot AI(月之暗面)正式公开了 Kimi K3.1 Pro 的模型权重。这一次,Kimi 带来的不仅是一个参数规模庞大的语言模型,更是一款面向复杂任务、长上下文处理和智能体应用设计的原生多模态模型。根据官方介绍,Kimi K3.1 Pro 基于 Kimi K3 进行后训练,通过覆盖数百个下游领域的大规模联合强化学习,重点提升了软件开发、3D 创作、金融研究、事实准确性以及 Agent 任务执行能力。其主要技术指标如下:
| 技术指标 | Kimi K3.1 Pro |
|---|---|
| 模型架构 | Mixture-of-Experts(MoE) |
| 总参数量 | 2.8T(约 2.8 万亿) |
| 单 Token 激活参数 | 104B(约 1040 亿) |
| Transformer 层数 | 93 |
| 专家数量 | 896 |
| 每 Token 选择专家 | 16 个路由专家 |
| 共享专家 | 2 个 |
| 最大上下文长度 | 1,048,576 Tokens |
| 注意力机制 | KDA + Gated DSA |
| 视觉编码器 | MoonViT-V2 |
| 视觉编码器参数 | 401M |
| 权重量化 | MXFP4,部分模块 BF16 |
| 支持模态 | 文本、图像 |
| 推荐推理引擎 | vLLM、SGLang、TokenSpeed |
| 开放协议 | Kimi K3.1 Pro License |
从参数规模来看,Kimi K3.1 Pro 已经进入万亿参数级模型的行列。但真正值得关注的,不只是模型有多大,而是它如何利用 MoE 架构,在计算效率和模型能力之间寻找平衡。
二、模型架构:2.8T 参数不代表每次都要计算 2.8T
2.1 MoE:用稀疏激活降低计算需求
Kimi K3.1 Pro 采用混合专家架构(Mixture-of-Experts,简称 MoE)。传统稠密模型通常会在每次前向传播中使用其大部分参数,而 MoE 模型通过路由机制,仅激活与当前输入相关的部分专家网络。Kimi K3.1 Pro 的核心特点是:
总参数规模约 2.8T。
每个 Token 激活约 104B 参数。
包含 896 个路由专家。
每个 Token 选择 16 个路由专家。
同时使用 2 个共享专家。
这样的架构能够在维持巨大模型容量的同时,减少单 Token 所需的计算量。
虽然每次计算只使用约 104B 参数,但模型仍然需要访问完整的专家权重。因此,不能按照一个普通 104B 模型的硬件需求,为 Kimi K3.1 Pro 配置服务器。这也是为什么 Kimi K3.1 Pro 的实际部署门槛依然很高。
2.2 KDA + Gated DSA:面向百万上下文的注意力架构
Kimi K3.1 Pro 的另一个重要变化是其混合注意力机制。模型共有 93 层,其中:
| 注意力类型 | 层数 | 主要作用 |
|---|---|---|
| Kimi Delta Attention(KDA) | 69 | 提高长序列处理效率 |
| Gated DeepSeek Sparse Attention(Gated DSA) | 24 | 稀疏检索重要历史信息 |
| 合计 | 93 | 建混合注意力架构 |
相较于 Kimi K3,K3.1 Pro 在相关注意力层中引入了 Gated DSA,通过稀疏索引机制选择重要的历史 Token。其中,DSA 的 Top-K 设置为 2048。这意味着模型不必在每次注意力计算中,对全部历史 Token 执行同等规模的密集注意力操作。对于长文档分析、大型代码仓库理解以及长期运行的 Agent,这种设计具有重要意义。不过,支持百万 Token 上下文,并不意味着普通部署环境能够低成本地运行百万上下文。上下文越长,缓存、显存、计算资源和推理延迟通常仍会增加。因此,实际部署时需要根据业务需求设置合理的上下文长度,而不是直接将最大值作为默认配置。
三、硬件需求:普通电脑能不能运行 Kimi K3.1 Pro?
这是很多开发者最关心的问题。
先给出结论:Kimi K3.1 Pro 原始开放权重更适合数据中心级多 GPU 服务器,不适合普通个人电脑直接部署。
3.1 模型权重究竟需要多少存储空间?
官方开放的模型采用混合精度存储。其中,MoE 路由专家权重使用 MXFP4,部分其他模块采用 BF16。根据模型仓库,目前公开权重文件的存储规模约为 1.56TB。需要区分三个概念:
第一,下载空间。
模型文件本身需要约 TB 级存储容量。
第二,加载内存。
实际推理需要容纳模型权重,还要考虑框架管理、运行时缓存及中间数据等开销。
第三,推理显存。
GPU 还需要为 KV Cache、计算工作区、并发请求等预留资源。
因此,即使服务器的总显存理论上能够放下权重,也不代表一定能稳定运行完整的百万上下文推理服务。此外,使用 CPU 内存卸载并不能消除这些资源需求,只是将部分存储压力转移到了内存和数据传输链路。
3.2 推荐硬件配置
结合当前公开的 vLLM 部署方案,可以将硬件选择划分为以下几个等级。
| 部署方案 | GPU 配置 | 总显存 | 建议 |
|---|---|---|---|
| 个人工作站 | 单张 RTX 5090 32GB | 32GB | 不建议部署原始模型 |
| 普通 GPU 服务器 | 8× H100 80GB | 640GB | 单节点不足以完整容纳权重 |
| 多节点 GPU 集群 | 16× H200 141GB | 2256GB | 理论容量充足,需额外验证兼容性 |
| 企业级 GPU 服务器 | 8× B300 268GB | 2144GB | 推荐部署方案之一 |
| 企业级 GPU 集群 | 8× GB300 288GB | 2304GB | 已有对应部署方案 |
| AMD GPU 服务器 | 8× MI355X 288GB | 2304GB | 已有公开适配方案 |
目前,vLLM 已公布基于 B300、GB300 和 MI355X 等硬件的 Kimi K3.1 Pro 部署方案。对于生产环境,应该优先参考已经验证的硬件组合,而不是单纯根据显存总容量进行采购。
3.3 NVIDIA 还是 AMD?
两种方案都有各自的优势。
NVIDIA GPU
适合已经采用 CUDA、vLLM、NVIDIA Dynamo 等技术体系的开发团队。其优势在于推理软件生态、GPU 通信、集群调度及生产部署工具相对成熟。
AMD Instinct GPU
适合希望使用 ROCm 技术栈,或者已经拥有 AMD 数据中心硬件的团队。AMD 已公开展示 Kimi K3.1 Pro 在 8 张 MI355X GPU 上使用 ATOM 和 vLLM 运行的方案。
这表明 Kimi K3.1 Pro 并非只能部署在 NVIDIA GPU 环境中。但无论选择哪种平台,都需要综合评估显存容量、GPU 互联、驱动兼容性和推理框架支持情况。
3.4 Mac 能否本地部署?
对于常见的 MacBook Air、MacBook Pro 和 Mac mini,直接部署完整 Kimi K3.1 Pro 并不现实。例如,16GB 或 32GB 统一内存的 Mac,无法容纳 TB 级模型权重。即便是配备较大统一内存的 Mac Studio,也仍然受到模型规模、内存容量以及推理框架适配限制。如果主要使用 Mac 进行 AI 应用开发,更合理的方案是:Mac 负责应用开发,云端 API 或远程 GPU 服务器负责模型推理。这样可以避免为了使用一个大模型而承担极高的本地硬件投入。对于有本地隐私需求的项目,可以选择其他经过验证的轻量级开放模型,在本地承担常规任务,再将复杂任务分配给远程模型。
四、模型部署:三种值得考虑的方案
Kimi K3.1 Pro 目前提供三种主要使用路径:
官方 API 接入。
使用 vLLM、SGLang 等框架私有化部署。
使用云端 GPU 集群部署并对外提供推理服务。
不同方案适合不同规模的开发者和企业。
4.1 方案一:官方 API,适合绝大多数开发者
如果目标是开发 Agent、AI 应用、自动化系统或企业内部工具,官方 API 通常是成本较低、实施较快的选择。Moonshot AI 提供兼容 OpenAI 和 Anthropic 接口风格的 API。开发者可以在现有 Python 项目中使用 OpenAI SDK 调用模型。
# 首先安装依赖:
pip install --upgrade openai
# 配置 API Key:
export KIMI_API_KEY="your-api-key"# 随后编写 Python 示例:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["KIMI_API_KEY"],
base_url="https://api.moonshot.ai/v1"
)
response = client.chat.completions.create(
model="kimi-k3.1-pro",
messages=[
{
"role": "user",
"content": "分析一个企业知识库 Agent 的系统架构"
}
],
temperature=1.0,
top_p=0.95,
reasoning_effort="high"
)
print(response.choices[0].message.content)其中:
model:指定模型名称。
reasoning_effort:控制推理强度。
temperature:控制采样随机性。
top_p:设置核采样参数。
Kimi K3.1 Pro 支持三档推理强度:
| 参数 | 适合场景 |
|---|---|
| low | 相对简单的推理任务 |
| high | 常规复杂任务 |
| max | 高复杂度推理任务 |
官方默认值为 max。
4.2 方案二:使用 vLLM 私有化部署
对于拥有高显存 GPU 集群的企业,vLLM 是目前官方推荐的推理引擎之一。vLLM 的优势在于:
GPU 并行推理。
大规模模型服务。
KV Cache 管理。
批处理调度。
OpenAI 兼容接口。
多 GPU 和多节点部署。
Kimi K3.1 Pro 对推理框架的版本和算子支持具有较高要求。因此,不建议简单执行普通版本的:
pip install vllm然后直接尝试加载完整模型。更稳妥的方式是使用针对 Kimi K3.1 Pro 验证过的专用镜像。以 vLLM 官方提供的 NVIDIA GB300 多节点部署方案为例,核心启动参数如下:
vllm serve moonshotai/Kimi-K3.1-Pro \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
这段命令用于展示核心推理参数,并非在任意服务器上都能直接运行的完整生产部署脚本。实际部署还需要配置:
兼容的 vLLM 版本或专用 Docker 镜像。
多节点通信。
GPU 和网络接口。
模型权重存储。
节点角色。
显存与 KV Cache 配额。
如果使用多节点部署,还需要配置 --nnodes、--node-rank、--master-addr 等参数。特别是在跨节点张量并行场景下,应优先使用适配的高速网络互联。模型启动后,可以通过兼容 OpenAI 的 HTTP API 调用推理服务。例如:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3.1-Pro",
    "messages": [
      {
        "role": "user",
        "content": "解释 MoE 模型的工作原理"
      }
    ],
    "temperature": 1.0,
    "top_p": 0.95
  }'
部署过程中应特别关注模型的首 Token 延迟、输出速度、显存占用以及不同上下文长度下的性能表现。
4.3 方案三:使用 SGLang 部署
SGLang 同样是 Kimi K3.1 Pro 官方推荐的推理框架。它适合需要优化模型服务性能、批量推理和复杂请求调度的应用。与 vLLM 类似,SGLang 需要针对模型架构选择兼容版本和部署参数。尤其是 Kimi K3.1 Pro 使用了混合注意力机制和特殊量化格式,不能默认所有通用推理配置都能正常工作。对于已有 SGLang 基础设施的团队,可以优先参考官方 Cookbook,进行小规模兼容性验证,再逐步扩大服务规模。
五、部署优化:真正的难点不只是加载模型
Kimi K3.1 Pro 的部署成本主要来自三个方面:模型权重、长上下文缓存,以及并发推理。
5.1 不要直接开启百万上下文
虽然模型支持约 100 万 Token,但大多数应用并不需要每次都使用如此长的上下文。例如:
| 应用类型 | 建议初始测试范围 |
|---|---|
| 普通问答 | 8K–16K |
| 代码辅助 | 16K–64K |
| 文档分析 | 32K–128K |
| 大型项目分析 | 128K–256K |
| 超长上下文研究 | 按实际需求扩展 |
以上为工程测试建议,并非官方硬件支持上限。建议从较小的上下文窗口开始,逐步测量显存、吞吐量和响应延迟。
5.2 合理使用 KV Cache
长上下文推理需要管理大量历史状态。随着上下文长度和并发数量增长,KV Cache 会成为影响服务容量的重要因素。Kimi K3.1 Pro 使用的稀疏注意力机制有助于控制部分注意力计算成本,但仍然需要缓存相关历史信息。vLLM 已针对该模型提供 Decode Context Parallelism(DCP)等优化方案。这种方式能够将部分缓存分布到多个 GPU,提升长上下文服务的容量。但缓存容量增加不代表推理一定更快。应根据实际负载,在响应速度和并发容量之间进行权衡。
5.3 采用分离式推理架构
对于需要处理大量并发请求的生产环境,可以考虑 Prefill/Decode Disaggregation。这种架构将推理划分为两个主要阶段:Prefill: 处理输入上下文,完成初始计算。Decode: 逐步生成输出 Token。通过分配不同的计算资源,可以分别优化长提示词处理和持续生成的性能。对于大型 Agent 平台,这种架构有利于进一步提高资源利用率。但它会增加集群通信、缓存传输和服务编排的复杂度,因此通常更适合较大规模的部署。
六、应用领域:Kimi K3.1 Pro 适合做什么?
Kimi K3.1 Pro 的价值并不局限于普通聊天。从官方披露的能力方向来看,其定位更接近能够调用工具、理解复杂信息并完成长周期任务的 Agent 基础模型。
6.1 软件开发与 Code Agent
软件开发是 Kimi K3.1 Pro 重点优化的领域之一。模型可以用于:
代码生成与修改。
多文件代码分析。
项目架构理解。
自动化测试辅助。
Bug 定位与修复建议。
软件工程文档生成。
长周期开发任务。
相比单纯的代码补全,Kimi K3.1 Pro 更值得关注的是复杂工程任务的处理能力。例如,用户提出:
“分析一个 Next.js 项目的整体架构,检查接口设计,并提出性能优化方案。”Agent 可以结合文件读取、代码搜索和测试工具,逐步完成任务。但需要说明的是,模型本身并不自动拥有文件系统或终端权限。真正执行代码修改、测试和部署,仍需要外部 Agent Harness、工具调用系统及权限管理机制。
6.2 企业知识库与智能文档分析
百万 Token 上下文和多模态能力,使 Kimi K3.1 Pro 适合处理复杂文档任务。例如:
企业制度分析。
多文档信息检索。
合同条款比较。
研究资料整合。
技术规范解析。
表格与图表信息理解。
在实际企业系统中,可以结合 RAG 构建知识检索与问答服务。推荐架构:
用户问题
   ↓
权限验证
   ↓
知识检索 / RAG
   ↓
上下文整理
   ↓
Kimi K3.1 Pro
   ↓
结果验证与引用
   ↓
返回答案6.3 金融研究与数据分析
金融研究也是 Kimi K3.1 Pro 官方重点介绍的能力方向。它可以辅助完成:
财务报告分析。
企业经营数据整理。
财务指标解释。
多期报告对比。
财务图表理解。
研究报告初稿生成。
例如,研究人员可以向系统提交多份财务报告,让模型提取收入、利润、现金流及其他关键指标,并进行横向比较对于复杂财务分析,建议采用:模型理解任务 + Python 计算 + 数据验证 + 结果解释
而不是仅依赖模型直接生成数字结论。涉及财务决策时,还需要人工核验数据来源、计算逻辑和结论。
6.4 3D 创作与 CAD 辅助
Kimi K3.1 Pro 的另一个重要应用方向是三维内容创作。官方介绍了其在 Blender、CAD 等工具相关任务中的能力。在实际应用中,可以结合外部工具实现:
3D 建模脚本生成。
参数化模型设计。
Blender Python 脚本辅助。
CAD 自动化建模。
场景结构规划。
模型参数调整。
例如,用户希望创建一个参数化机械零件。Agent 可以根据尺寸要求生成建模脚本,再调用相应 CAD 工具进行构建与验证。这类系统的关键不只是语言模型,而是模型与专业软件工具的协作能力。
6.5 多模态视觉理解
Kimi K3.1 Pro 使用 MoonViT-V2 视觉编码器,具备原生图像理解能力。适合的应用包括:
图表分析。
文档页面理解。
图片内容描述。
界面截图分析。
视觉问答。
复杂图文推理。
例如,用户上传一张系统架构图,模型可以辅助解释其中的模块、连接关系及潜在设计问题。不过,视觉识别结果仍可能存在遗漏或误判。对于需要精确识别的任务,可以结合专业 OCR、图像处理及结构化验证工具。
七、实际性能:如何理解官方基准测试?
Moonshot AI 公布了 Kimi K3.1 Pro 在多个领域的评测数据。这里选择部分具有代表性的结果:
| 评测项目 | Kimi K3.1 Pro | 主要考察能力 |
|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 终端编程任务 |
| SWE Marathon v1.1 | 51.7 | 软件工程任务 |
| BrowseComp | 92.1 | 复杂信息检索 |
| HLE-Full w/ tools | 70.0 | 工具辅助综合推理 |
| MMMU-Pro w/ Python | 90.0 | 多模态理解与推理 |
| OfficeQA Pro v2 | 64.4 | 办公文档问答 |
| GPQA-Diamond | 94.2 | 专业知识推理 |
| OSWorld V2.1 | 79.6 | 计算机环境操作任务 |
上述数据来自模型官方评测表。这些结果表明,Kimi K3.1 Pro 在编程、工具调用和多模态推理方面具有较强的竞争力。但不同基准测试使用的任务环境、工具配置、推理预算和评分规则并不完全一致。因此,不宜仅凭某一个排行榜分数判断模型在全部应用场景中的表现。对于准备部署的企业,更有价值的方式是建立符合自身业务需求的测试集。例如:
代码任务完成率。
工具调用成功率。
文档事实准确率。
平均响应延迟。
单任务 Token 消耗。
推理服务稳定性。
只有将模型能力与业务成本结合起来,才能判断它是否值得部署。
八、API 还是私有化部署?如何选择?
对于大多数开发者而言,最重要的不是模型能否部署,而是部署是否具有经济合理性。下面给出不同使用场景的建议。
| 使用场景 | 推荐方案 | 主要原因 |
|---|---|---|
| 个人开发者 | 官方 API | 无须购买 GPU |
| AI 应用原型 | 官方 API | 开发速度快 |
| 小型开发团队 | API + 本地轻量模型 | 灵活控制成本 |
| 中型企业 | API 或托管推理服务 | 降低运维复杂度 |
| 大型企业 | 私有化部署 | 便于统一资源和数据管理 |
| AI 推理服务商 | GPU 集群部署 | 可集中管理高并发负载 |
| 科研机构 | API 或专用 GPU 集群 | 按研究规模选择 |
8.1 API 的优势
API 接入最直接的优势是避免前期硬件投入。开发团队只需要管理:
API 凭据。
请求参数。
上下文。
调用费用。
数据安全策略。
比较适合请求量不确定、业务仍在快速迭代的项目。
8.2 私有化部署的优势
私有化部署则更适合:
已经具备数据中心 GPU 资源。
存在严格的数据驻留要求。
需要深度控制推理过程。
有长期稳定的大规模推理需求。
需要与企业内部基础设施集成。
不过,开放权重不代表没有许可限制。Kimi K3.1 Pro 使用专门的 Kimi K3.1 Pro License。企业在私有化部署、二次开发或提供商业服务前,应阅读对应许可证条款。
8.3 部署成本不只有 GPU
完整的成本评估还应该包括:
硬件成本: GPU、CPU、内存、存储和网络设备。
运行成本: 电力、散热、网络流量。
运维成本: GPU 驱动、框架升级、故障排查与监控。
业务成本: 响应延迟、服务可用性、单位任务费用。
对于个人开发者或小型团队,使用 API 往往是更合理的起点。而对于大型企业,私有化部署是否划算,则取决于实际负载和资源利用率。
九、从大模型到 Agent:真正值得关注的应用方向
Kimi K3.1 Pro 的一个重要特点,是它并非只围绕文本生成能力展开优化。从官方强调的编程、工具调用、长周期任务和多模态理解能力来看,它更适合成为复杂 Agent 系统中的推理核心。一个典型的企业级 Agent 系统,可以采用以下架构:
用户需求
    │
    ▼
Agent Harness
    │
    ├── 任务规划
    ├── 上下文管理
    ├── 工具权限控制
    ├── 执行状态管理
    └── 人工确认
    │
    ▼
模型推理层
    │
    ├── Kimi K3.1 Pro
    ├── 其他云端模型
    └── 本地轻量模型
    │
    ▼
工具与数据层
    │
    ├── MCP Server
    ├── 数据库
    ├── 文件系统
    ├── Python
    ├── 浏览器工具
    └── 业务 API
    │
    ▼
执行结果验证
    │
    ▼
任务结果交付
在这种架构下,Kimi K3.1 Pro 负责复杂推理和决策辅助。工具系统负责实际操作。Agent Harness 则负责管理执行过程、权限、状态和异常恢复。