

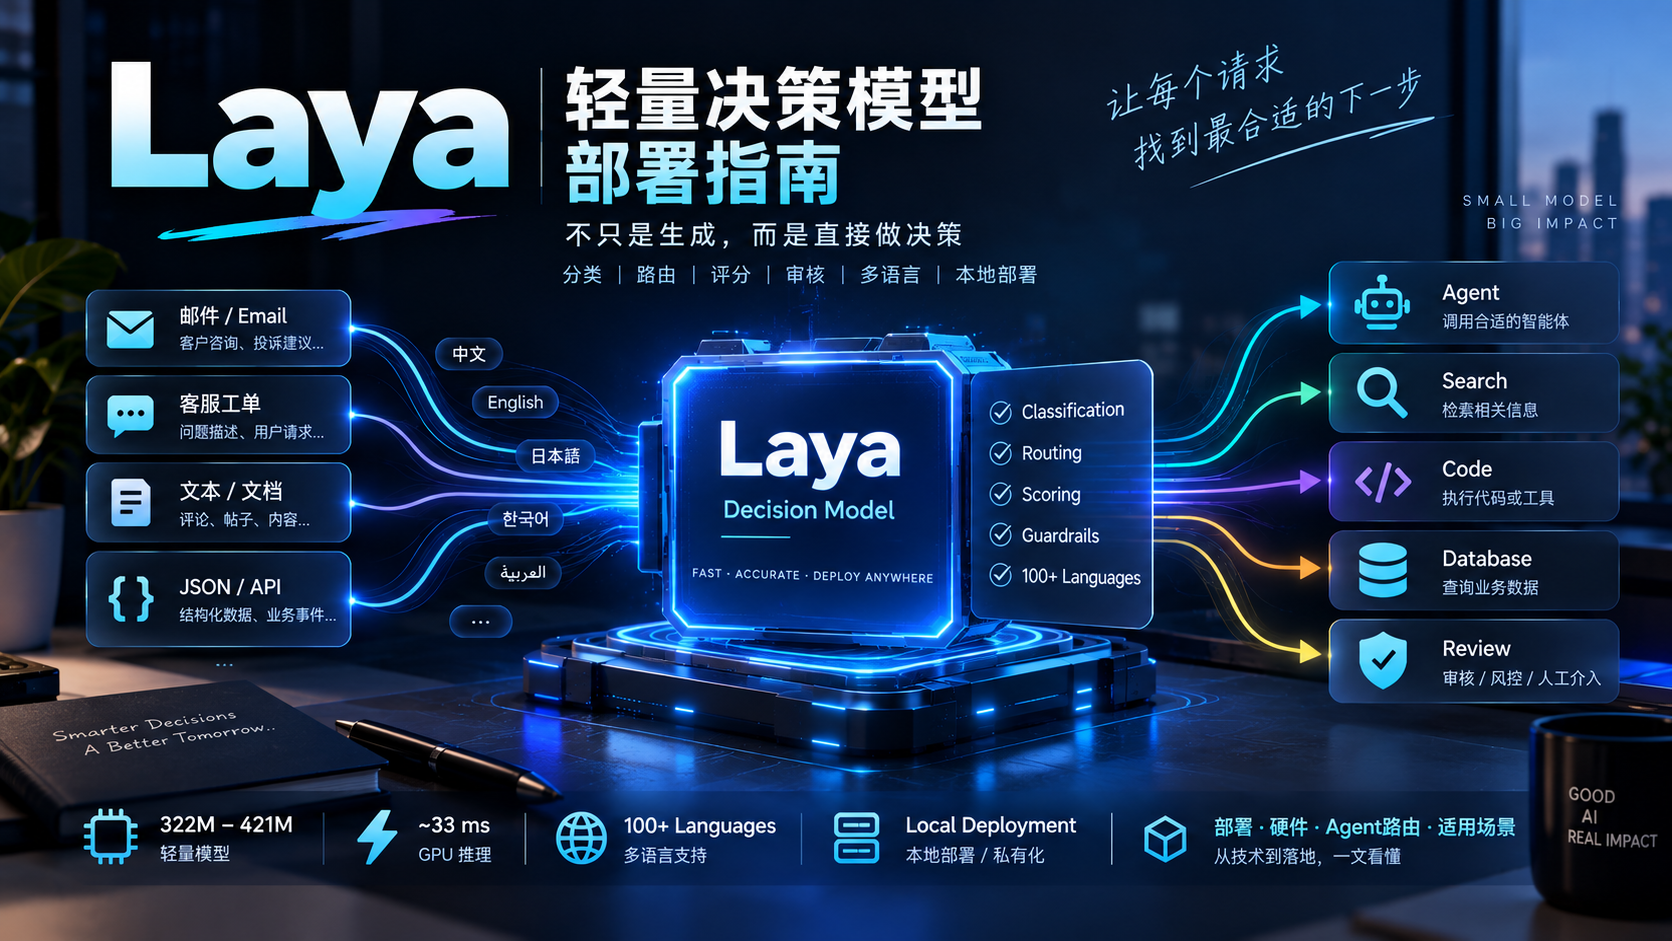
最近看到一个比较特别的模型:Laya。 它不是聊天模型,也不会生成长文本,而是专门做一件事:
把输入内容快速转换成结构化决策。
比如给它一封邮件、一个工单、一段文本,甚至一段JSON,它可以直接判断:
属于哪个部门
是否需要退款
风险等级是多少
是否需要人工处理
是否应该调用某个Agent工具
而且这些问题可以在一次前向推理里同时完成。 对于客服分流、Agent路由、内容审核、风控判断这类场景,它可能比直接调用大语言模型更合适。
一、Laya有哪几个模型?
目前主要可以关注三个Checkpoint:
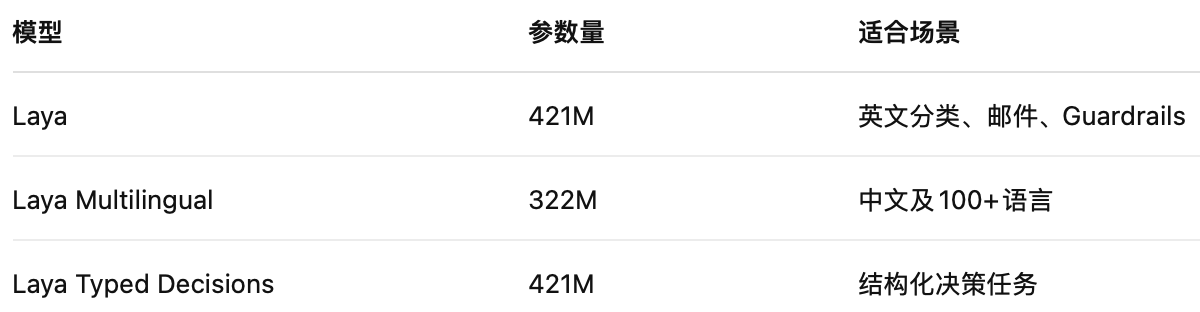
如果实际业务里包含中文,优先考虑:Laya Multilingual 如果是针对固定业务做过专门微调的决策系统,则可以考虑 Typed Decisions 方向。
二、部署难度并不高
官方提供了Python SDK,基础安装可以直接:
pip install laya单模型加载:
import laya

agent = laya.load(
    "convaiinnovations/laya",
    subfolder="multilingual"
)
然后传入状态和问题:
result = agent.predict(state, questions)如果你的系统同时处理英文、中文以及其他语言,更推荐直接使用Router:
from laya import Router

router = Router(preload=True)
Router会根据输入语言自动选择对应模型。生产环境建议使用:
Router(preload=True)而不是每次临时加载模型。因为模型真正的推理时间只有几十毫秒,但冷启动和重新加载Checkpoint可能需要数秒。
三、需要什么硬件?
Laya最大的优势之一,就是模型规模并不大。主模型大约只有:322M~421M参数 这和动辄7B、32B、70B的大语言模型完全不是一个硬件级别。
轻量体验
如果只是:
本地测试
开发调试
小规模调用
普通CPU机器就可以运行。官方数据中,CPU推理大约在数百毫秒级,因此个人电脑、普通服务器都可以尝试。
推荐部署
如果用于:
API服务
Agent路由
工单实时分类
中等并发业务
建议使用一张主流NVIDIA GPU。 例如:
T4 16GB
L4 24GB
RTX 3060 12GB
RTX 4060 Ti 16GB
RTX 4070及以上
因为模型本身体量不大,通常不需要为了它单独采购高端大显存卡。 官方在Tesla T4上的测试中,Multilingual模型单问题推理约:32.8 ms 一次处理10个问题约:72.3 ms 也就是说,真正适合它的场景不是“慢慢生成文本”,而是:
高频、批量、快速判断。
四、显存怎么规划?
Laya Multilingual权重大约647MB,英文模型约808MB。 实际运行时还要考虑:
PyTorch运行时
Encoder中间激活
Batch
多Checkpoint同时驻留
因此实际部署时,建议至少预留几GB显存。单模型服务通常不需要特别大的GPU。 如果使用:
Router(preload=True)并让多个Checkpoint同时驻留,就需要额外增加显存预算。如果资源有限,也可以:
Router(max_loaded=1)但频繁中英文切换会带来模型重新加载问题。
五、它最适合哪些领域?
1. Agent路由
这是我认为非常适合Laya的场景。例如用户输入后,先判断:
是否需要搜索?
是否需要调用数据库?
是否需要写代码?
是否需要交给大模型推理?
整体架构可以变成:
用户请求
   ↓
Laya
快速判断
   ↓
Router
   ↓
LLM / Search / Code / Database
这样不需要每个请求都先调用一个大模型。
2. 客服与工单系统
一次判断:
所属部门
紧急程度
投诉类型
退款需求
流失风险
是否人工介入
相比让LLM生成一段JSON,Laya更接近真正的分类和决策组件。
3. 内容审核与Guardrails
例如:
是否违规
风险类型
风险等级
是否阻止执行
是否需要人工复核
特别适合作为大模型前后的一层轻量Guardrail。
4. 邮件自动分流
企业邮箱可以先经过Laya判断:
销售
技术支持
财务
投诉
垃圾邮件
紧急邮件
然后再进入对应工作流。
5. 风险评分
它还可以用于:
交易风险
账号风险
退款风险
流失风险
审核风险官方也明确建议在自己的业务数据上重新做概率校准。
六、它不适合什么?
Laya并不是缩小版ChatGPT。它不适合:
写文章
总结长文
多步推理
复杂Agent Planning
开放式问答
另外,当一个问题拥有几十甚至上百个候选标签时,默认配置下性能也可能下降。因此它更适合:
少量明确候选项 + 高频决策
而不是:
一个模型解决所有问题。
七、真正值得关注的是“模型分工”
过去做AI应用,经常是什么事情都交给LLM。 但生产系统更合理的架构,可能会逐渐变成:
Laya
分类 / 路由 / 风险判断
        ↓
LLM
复杂推理 / 生成 / Planning
        ↓
Tool
执行真实任务
简单判断交给几亿参数的小模型。复杂问题再交给大模型。这样可以降低:
推理延迟
GPU成本
API费用
输出解析复杂度
Laya真正有意思的地方,并不是它要取代LLM。
对于大量确定性更强的业务判断,一个轻量、快速、可以本地部署的决策模型,反而可能更加实用。