

如果一台普通电脑,就能本地运行一个支持 13万上下文、代码推理、工具调用和 Agent 任务 的大模型,会是什么体验? OpenBMB 推出的 MiniCPM5-2B,正在把“小模型本地化”这件事继续往前推。 它并不是单纯追求参数更小,而是把目标直接放在了: 端侧设备、本地 AI 助手、Coding Agent、工具调用以及资源受限环境。 对于想在 Mac、Windows PC、工作站甚至边缘设备上部署 AI 的开发者来说,这类模型可能比动辄几十 B 的大模型更有实际意义。
一、MiniCPM5-2B 到底有多大?
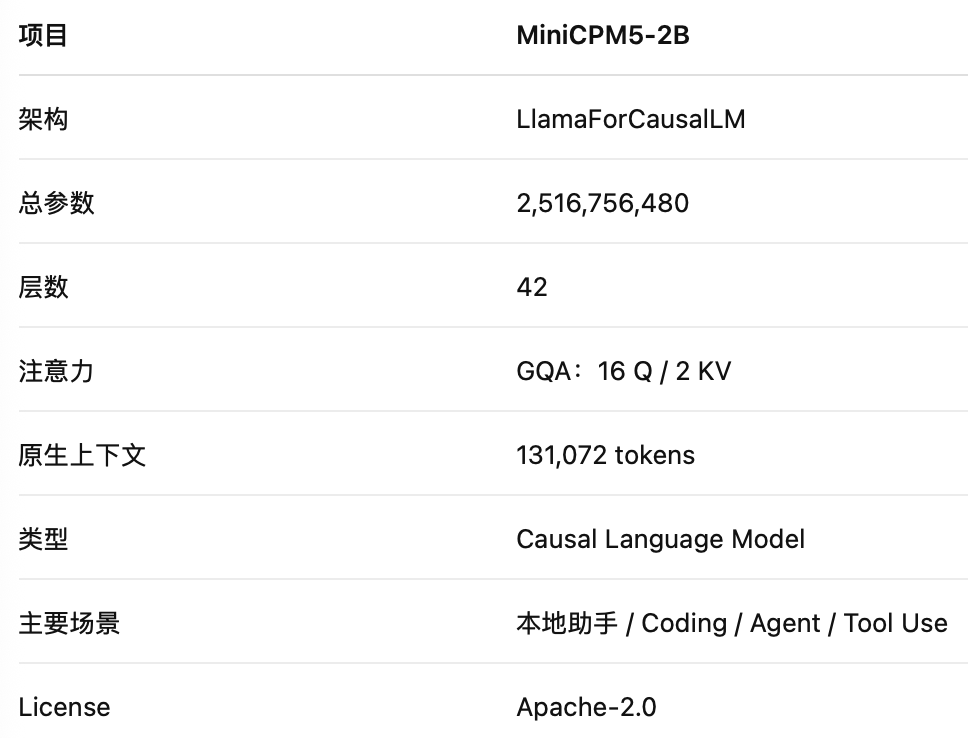
虽然名字叫 2B,但 MiniCPM5-2B 实际总参数量约为: 2.52B,也就是约25亿参数。 核心规格如下:
二、2B 模型,能力真的够用吗?
MiniCPM5-2B 最有意思的地方,并不是“小”。而是: OpenBMB 把相当多的训练资源投入到了代码、数学、长上下文、工具调用和 Agent 能力上。 根据官方公布的对比结果,在其选取的评测集合中,MiniCPM5-2B 平均分为 53.9。 部分指标尤其值得 Agent 开发者关注:
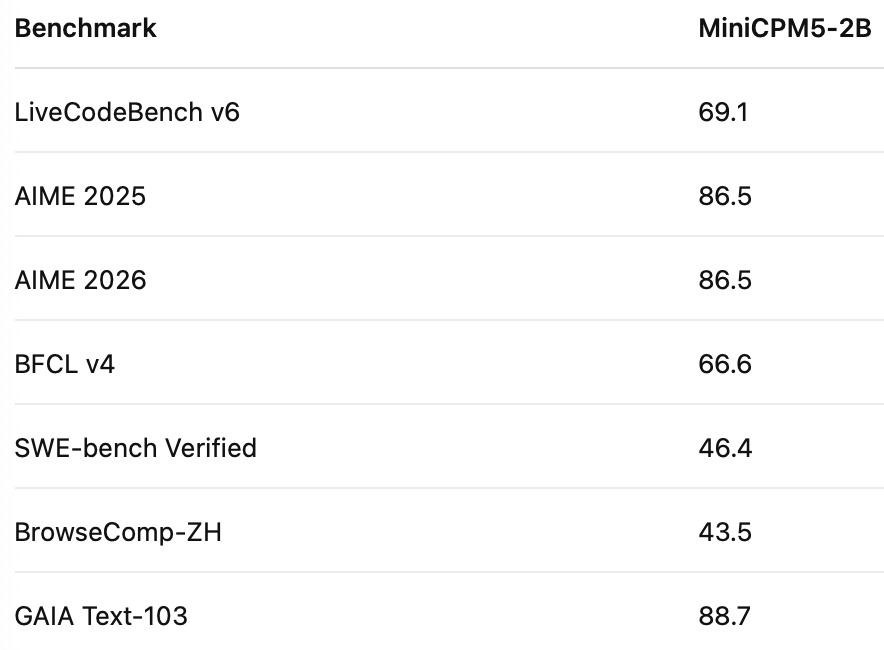
需要注意,这些成绩来自官方报告中的特定评测配置,并不能简单理解成 MiniCPM5-2B 在所有实际任务里都能超过更大的模型。
但它至少释放了一个非常明确的信号: 2B 级模型已经不只是“能聊天的小模型”,而是在向本地 Agent 执行模型发展。
三、为什么它适合本地部署?
MiniCPM5-2B 使用标准 LlamaForCausalLM 架构。这一点很重要。因为开发者不需要为了它维护一套特殊推理内核。目前已经可以围绕不同硬件选择: Transformers、vLLM、SGLang、llama.cpp、Ollama、LM Studio、MLX、LiteRT-LM 等路线。 模型本身也提供 BF16、GGUF、MLX 4bit、GPTQ 等不同格式。 所以部署逻辑非常清晰:
服务器 GPU → vLLM / SGLang
普通 PC → Ollama / llama.cpp / LM Studio
Apple Silicon → MLX / Ollama
移动与边缘设备 → LiteRT-LM
这也是 MiniCPM5-2B 比较适合做“本地 AI 基础模型”的原因之一。
四、什么电脑适合跑?
如果只是想体验 MiniCPM5-2B,其实硬件门槛并不高。
方案一:8GB 内存/显存级设备
Q4_K_M 等 4bit 量化版本:模型文件本身大约只有 1~2GB 级别。 适合: 轻量聊天、本地知识助手、简单代码辅助、结构化文本处理以及 Agent 实验。 但是千万别看到“131K”就直接把上下文拉满。 设备能加载模型,不代表满上下文时依然拥有理想的性能和内存余量。
方案二:16GB 统一内存 Apple Silicon
这是我认为很有意思的一档。例如: M1 / M2 / M3 / M4 / M5 系列 16GB Mac 可以优先考虑: MLX 4bit 或 GGUF Q4/Q8。 尤其 MLX 是针对 Apple Silicon 优化的推理生态,在 Mac 本地运行这种 2B 级模型非常合适。 如果你的 Mac 只有 16GB,也没必要执着 BF16。4bit 版本已经足够拿来做大量本地 Agent 实验。
方案三:NVIDIA 8GB 显存
例如 RTX 4060 8GB 这一档。 优先: Q4_K_M / Q8 等量化模型。 2.5B 参数的优势在这里就体现出来了: 你不需要一张 24GB 显存的高端卡,普通消费级显卡也能把模型放到 GPU 上运行。
方案四:16GB+ NVIDIA 显存
如果拥有 16GB 或更大的显存,就可以考虑更高精度模型,并尝试: SGLang / vLLM + MiniCPM5-2B 这一组合更加适合: API 服务、局域网 AI 服务、Agent 后端、多应用共享模型以及开发测试环境。
五、最简单的方法:Ollama
如果只是想最快把 MiniCPM5-2B 跑起来,我仍然推荐:Ollama。 原因很简单: 安装、模型管理、启动服务、REST API、OpenAI 兼容接口基本都给你准备好了。 目前 Ollama 社区已经存在基于 MiniCPM5-2B 构建的模型,例如 oamazonasgabriel/minicpm-2b 需要特别说明: 这是社区维护的 Ollama 模型,并非 OpenBMB 官方 Ollama 仓库。 因此生产环境使用前,建议核对模型来源、量化方式、Modelfile 与上游版本。
六、Ollama 一条命令跑起来
安装 Ollama 后,可以直接拉取 Q4_K_M:
ollama pull oamazonasgabriel/minicpm-2b:q4_k_m
# 然后运行:
ollama run oamazonasgabriel/minicpm-2b:q4_k_m
就这么简单。 如果是 Apple Silicon,还可以尝试社区提供的 MLX 版本:
ollama pull oamazonasgabriel/minicpm-2b:mlx
# 运行:
ollama run oamazonasgabriel/minicpm-2b:mlx
社区页面列出的模型体积大致为:
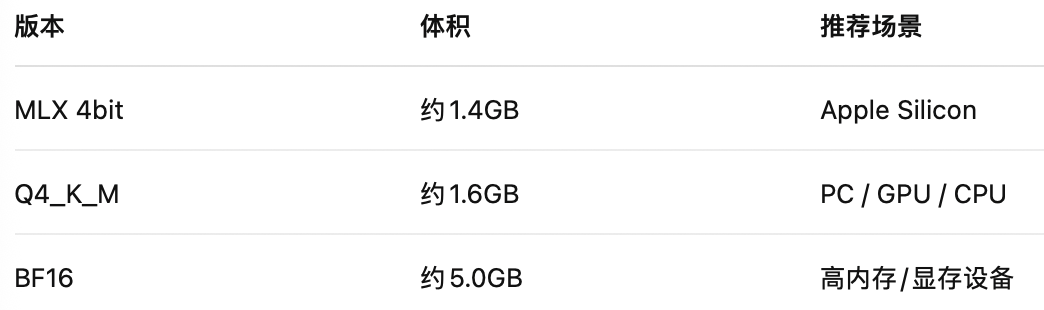
普通用户建议优先从 Q4_K_M 开始。 Mac 用户则可以重点比较 MLX 4bit 与 GGUF 在自己设备上的实际速度和内存占用。
七、Ollama 不只是聊天,还能作为 API
真正有价值的地方其实在这里。Ollama 启动之后,本机就拥有了一个模型服务。默认服务通常运行在:
127.0.0.1:11434于是你的 Python、JavaScript、桌面应用或者 Agent 都可以调用它。例如 Python:
pip install ollamaimport ollama
response = ollama.chat(
model="oamazonasgabriel/minicpm-2b:q4_k_m",
messages=[
{
"role": "user",
"content": "使用 Python 编写一个读取 JSON 文件的函数"
}
]
)
print(response.message.content)这时候 MiniCPM5-2B 就不再是一个“聊天软件”。而是:运行在你电脑上的本地 AI 推理后端。
八、还能接 Agent 框架
MiniCPM5-2B 本身重点强化了工具使用和 Agent 能力。所以它非常适合拿来研究:本地 Agent。 例如:
用户
 ↓
Agent Harness
 ↓
MiniCPM5-2B
 ↓
判断任务
 ↓
调用 Tool
 ↓
文件 / API / 数据库 / 搜索
 ↓
结果返回模型
 ↓
最终回答
这才是 2B 小模型真正值得关注的方向。未来本地 Agent 未必需要所有任务都交给几十 B、几百 B 参数的大模型。完全可以采用:
MiniCPM5-2B
      ↓
本地快速决策
      ↓
简单任务 → 本地直接执行
复杂任务 → 路由到更强模型九、工具调用要注意一个问题
MiniCPM5-2B 的工具调用使用其特定格式。如果你的目标是认真测试 Function Calling 或 Agent Tool Use,官方目前更推荐使用 SGLang。 启动时可以配置:
--tool-call-parser minicpm5SGLang 可以把模型产生的工具调用解析成 OpenAI 兼容的 tool_calls。 所以部署方案可以简单理解成:
聊天 / 本地体验 → Ollama
Apple Silicon → MLX
CPU / GGUF → llama.cpp
GPU API 服务 → vLLM
Agent + Tool Calling → SGLang
十、MiniCPM5-2B 最适合做什么?
我认为它真正值得尝试的不是普通聊天。而是下面这些本地场景: ① 本地 AI 助手 文件总结、文本处理、信息提取、办公自动化。 ② Coding Agent 代码解释、简单代码生成、Bug 分析以及本地开发工具辅助。 ③ RAG 知识库 把 Embedding、向量数据库和 MiniCPM5-2B 放在本机或局域网里,搭建完全本地化的知识助手。 ④ Agent Tool Calling 连接文件系统、数据库、HTTP API、MCP、Skill 等工具。 ⑤ Agent 路由模型 让 2B 模型负责: 任务分类、意图识别、工具选择、执行路由。 复杂问题再交给更大的模型。 ⑥ 边缘 AI MiniCPM5-2B 同时提供 LiteRT-LM 等设备端部署路线,使它可以继续向移动设备和 IoT 场景延伸。