

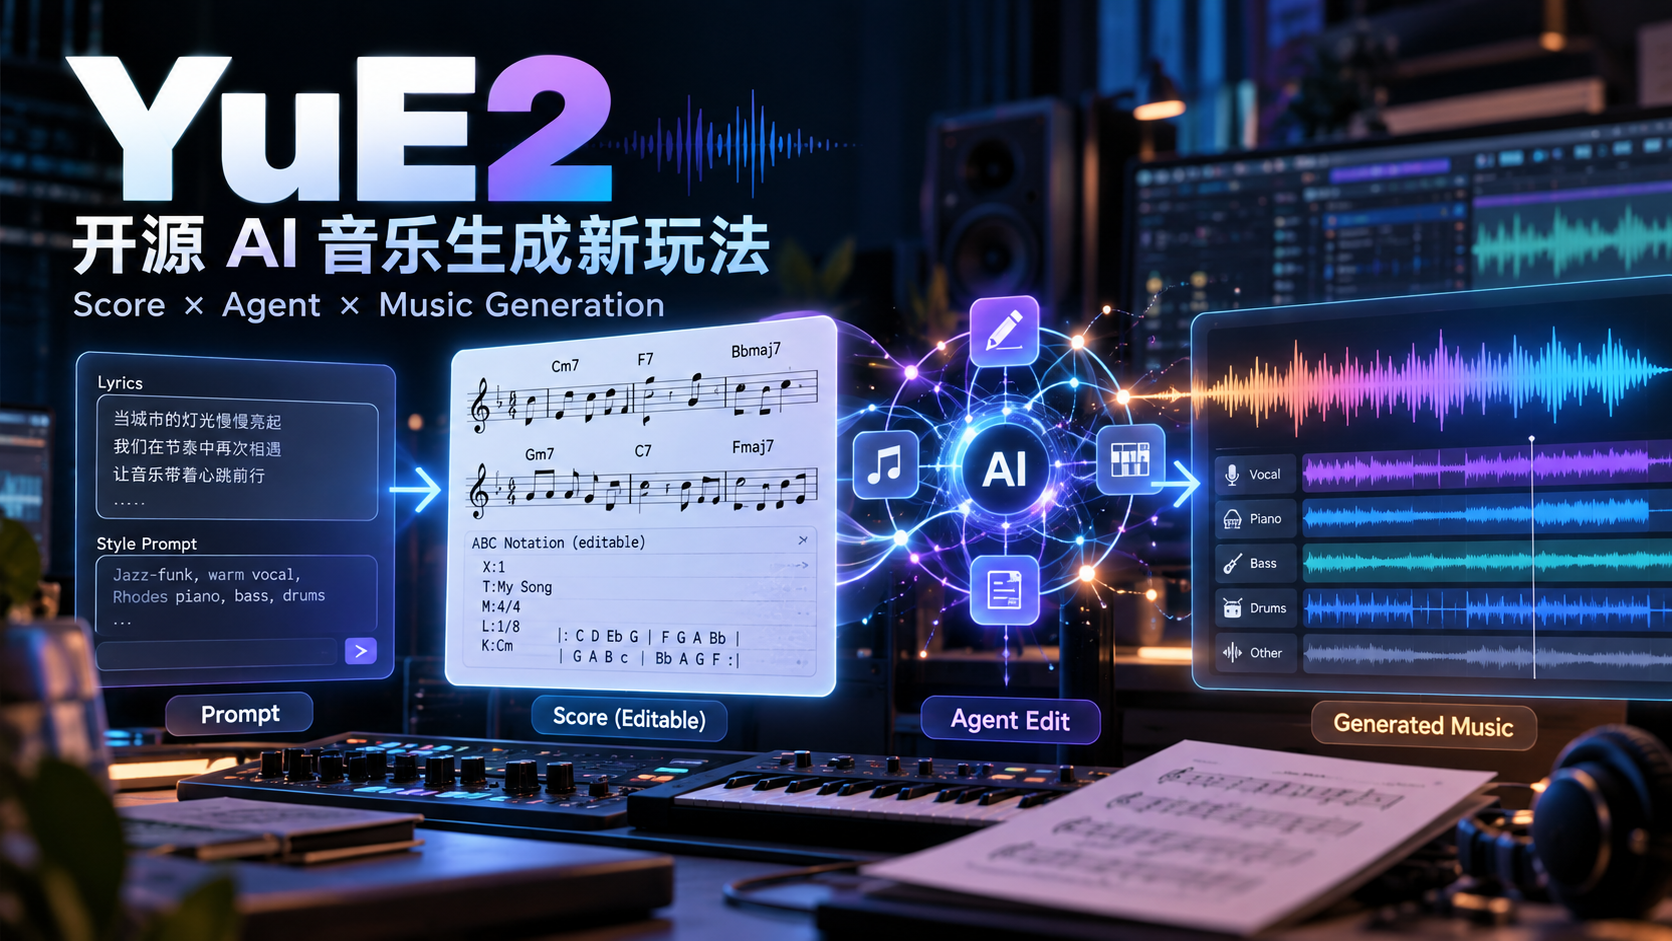
AI 音乐生成已经不是什么新鲜事了。 输入一句风格描述,再给一段歌词,等待几十秒,一首带有人声和伴奏的歌曲就能生成出来。但如果继续追问一个问题: 生成之后,我能不能真正“修改”这首歌? 这恰恰是很多音乐生成模型比较尴尬的地方。生成结果更像一个最终音频,而不是一个可以继续编排、调整和迭代的音乐工程。 YuE2 给出了另一种思路:不仅生成歌曲,还在生成过程中引入可编辑的符号乐谱(Symbolic Score),甚至可以让 Agent 参与乐谱修改。 这让 AI 音乐生成开始从“一次生成”向“生成—编辑—再生成”的工作流演进。
01|YuE2 是什么?
YuE2 是一个面向完整歌曲生成的开源音乐模型。它可以根据:
歌词
音乐风格提示词
生成包含人声与伴奏的完整歌曲,并支持最高约 5 分钟的长音乐生成。例如输入:
中文女声、新迪斯科、放克、合成器贝斯、舞曲节奏
再提供对应歌词,YuE2 就可以据此完成整首歌曲的规划和生成。但真正让 YuE2 有意思的,并不只是“能生成歌”。它在歌曲生成之前,可以先生成一份符号音乐规划。简单理解就是:
先写谱,再唱歌。
02|三种生成模式:先规划还是直接生成?
YuE2 提供了三种主要生成方式,对应不同程度的音乐规划。
Full:旋律 + 和弦规划
cot="full"这是默认模式。模型会先规划旋律和和弦,再根据规划结果生成最终音频。整个流程可以理解为:
歌词 + 风格
      ↓
旋律与和弦规划
      ↓
语义音乐 Token
      ↓
声学表示
      ↓
完整歌曲
这种方式适合从零创作完整歌曲。
Melody:只规划旋律
cot="melody"该模式只生成旋律,不生成和弦规划。它尤其适合 Cover 场景,因为可以尽可能保留原始旋律,同时让模型重新处理编曲和音乐风格。
Off:关闭符号规划
cot="off"模型不再提前生成符号乐谱,而是直接进入音乐生成过程。速度会更快,同时模型也拥有更大的自由发挥空间。
03|真正关键的是:乐谱可以编辑
YuE2 的符号规划并不是模型内部一个完全不可见的中间状态。生成结果可以保存为 ABC 乐谱,例如:
outputs/song/score.abcABC notation 是一种文本化的音乐记谱方式。这意味着原本难以直接修改的“AI 音乐生成结果”,开始拥有一个可以被程序、开发者甚至大语言模型处理的中间表示。 你可以先只执行规划:
plan = pipe.plan(
    lyrics=lyrics,
    style_prompt=style,
    cot="full",
)
得到乐谱之后进行修改,再继续生成音频。于是整个音乐生成工作流发生了变化:
Prompt
  ↓
音乐规划
  ↓
ABC 乐谱
  ↓
人工 / Agent 编辑
  ↓
YuE2 再生成
  ↓
新版本歌曲
这比传统的“重新改 Prompt 抽卡”更加接近真正的音乐编辑流程。
04|Agent 开始进入音乐生成工作流
ABC 乐谱还有一个很重要的特点:它本质上是文本。 而文本恰恰是大语言模型和 Agent 非常擅长处理的数据类型。例如用户可以提出:
副歌旋律保持不变,但重新设计和弦,让整体情绪更明亮。
Agent 可以读取 ABC 乐谱,分析旋律、和弦以及结构,然后修改对应内容。修改后的乐谱重新交给 YuE2,就可以生成新的音频版本。于是一个音乐 Agent 的基本闭环就出现了:
用户反馈
   ↓
Agent 理解修改需求
   ↓
读取 ABC 乐谱
   ↓
修改旋律 / 和弦 / 歌词 / 风格
   ↓
YuE2 重新生成
   ↓
用户试听
   ↓
继续反馈
如果要求严格重新配和弦,还可以要求 Agent 保持旋律音高与节奏不变,只调整和声结构。从 Agent 工程角度看,这一点很有价值。 因为 YuE2 不再只是一个单纯的“音乐生成模型”,它开始具备成为音乐 Agent 执行器的可能。
05|还能拿现有歌曲做 Cover
YuE2 还支持 Cover 工作流。官方提供的思路是先使用 SheetSage2 对参考歌曲进行转录,得到旋律 ABC 文件:
melody.abc再准备:
歌词
新的风格 Prompt
原歌曲旋律
随后使用:
cot="melody"进行生成。例如:
原歌曲旋律
+
新的风格描述
+
歌词
      ↓
YuE2
      ↓
重新编曲后的歌曲
如果还希望控制和声,则可以提供包含和弦的完整乐谱,并使用 Full 模式。这让 Cover 不再只是“参考音频风格迁移”,而是可以从旋律层面进行结构化控制。 需要注意的是,实际使用已有作品进行 Cover 或发布生成内容时,仍需自行确认相应作品的版权和授权条件。
06|YuE2 的模型架构
YuE2 的整体架构也比较有意思。它并不是简单地让一个 Transformer 直接预测最终音频,而是采用了多阶段生成方式。 核心可以概括为:
Lyrics + Style Prompt
        ↓
AR-NAR Hybrid Transformer
        ↓
Symbolic Score
        +
Semantic Tokens
        ↓
Flow Matching
        ↓
Acoustic Latent
        ↓
VAE
        ↓
48kHz Stereo Audio
其中,一个 AR–NAR 混合 Transformer Backbone 同时负责符号乐谱和语义 Token 的生成。随后通过 Flow Matching 生成声学潜变量,最终再由 VAE 解码成 48kHz 立体声音频。 这种设计把:音乐结构 → 音乐语义 → 声学细节 进行了相对明确的分层。这也是为什么 YuE2 能够把“乐谱编辑”插入歌曲生成流程。
07|本地部署需要什么配置?
YuE2 官方提供的快速开始环境主要面向:
Linux
Python 3.10+
NVIDIA GPU
BF16
推荐准备 24GB 显存 GPU + 24GB 系统内存。安装 Hugging Face Hub:
python -m pip install huggingface-hub==0.36.2下载推理包:
hf download m-a-p/YuE2-3B \
  yue2_infer-0.1.5-py3-none-any.whl \
  --local-dir .
安装:
python -m pip install \
  ./yue2_infer-0.1.5-py3-none-any.whl
随后即可通过 Python 加载:
from yue2 import YuE2Pipeline

pipe = YuE2Pipeline.from_pretrained(
    "m-a-p/YuE2-3B",
    device="cuda"
)
基础生成时提供歌词和风格描述即可。如果希望提高文本条件约束,还可以调整:
cfg_scale=1.2数值提高后,模型会更倾向于遵循文本条件,但实际效果仍需要根据具体歌曲进行测试。
08|一张 RTX 4090 跑起来怎么样?
官方给出的测试数据里,RTX 4090 24GB 已经可以完成单歌曲推理。以约 214 秒的生成歌曲为例:
| 模式 | 生成耗时 | 音频长度 | 峰值显存 |
|---|---|---|---|
| Full | 71.04s | 214.85s | 11.18 GiB |
| Melody | 68.68s | 214.67s | 11.02 GiB |
| Off | 57.91s | 196.88s | 11.09 GiB |
也就是说,在官方这一测试条件下,RTX 4090 使用 Full 模式生成约 3.6 分钟歌曲需要约 71 秒。最大上下文测试中的峰值显存约为 14.08 GiB。 不过官方依然建议使用 24GB GPU,因为实际显存占用还会受到歌曲长度、上下文和运行环境等因素影响。
09|它的生成质量怎么样?
YuE2 在 WildSongBench 上进行了测试。该 Benchmark 包含 192 个 Prompt,覆盖多种音乐风格。 部分结果如下:
| 模型 | SongBench 平均分 |
|---|---|
| YuE2 | 6.7316 |
| YuE2 Best-of-8 | 6.9632 |
| Suno v5 | 6.8721 |
| Suno v6 | 6.5562 |
| Mureka 9 | 6.9377 |
| MiniMax Music 3 | 6.2830 |
按照该测试提供的数据,YuE2 Best-of-8 的 SongBench 平均分达到 6.9632。不过这里需要注意:
Benchmark 并不等于所有实际音乐场景中的绝对体验。
Best-of-8 本身也意味着从多个候选结果中进行选择,因此它与单次生成结果不能简单画等号。 对于音乐模型来说,最终效果仍然受到音乐类型、歌词、Prompt、采样策略和主观审美等因素影响。
10|YuE2 真正值得关注的是什么?
如果只是看“AI 能不能生成一首歌”,YuE2 并不是第一个做到这一点的模型。 真正值得关注的是它正在尝试解决另一个问题:AI 生成出来的音乐,如何继续被编辑? 从:
Prompt → Audio变成:
Prompt
  ↓
Plan
  ↓
Score
  ↓
Edit
  ↓
Audio
  ↓
Feedback
  ↓
Edit Again
中间增加一个结构化、可编辑的乐谱层之后,音乐生成就不再只是一次性的黑盒输出。 开发者可以在这里接入:
LLM
Agent
乐谱编辑器
自动和声系统
音乐分析模型
人机协同编辑界面
最终甚至可以形成一个完整的:AI Music Agent。 它不是简单接受一句 Prompt 然后生成 MP3,而是能够理解修改意见、调整乐谱、重新编曲并不断迭代。