

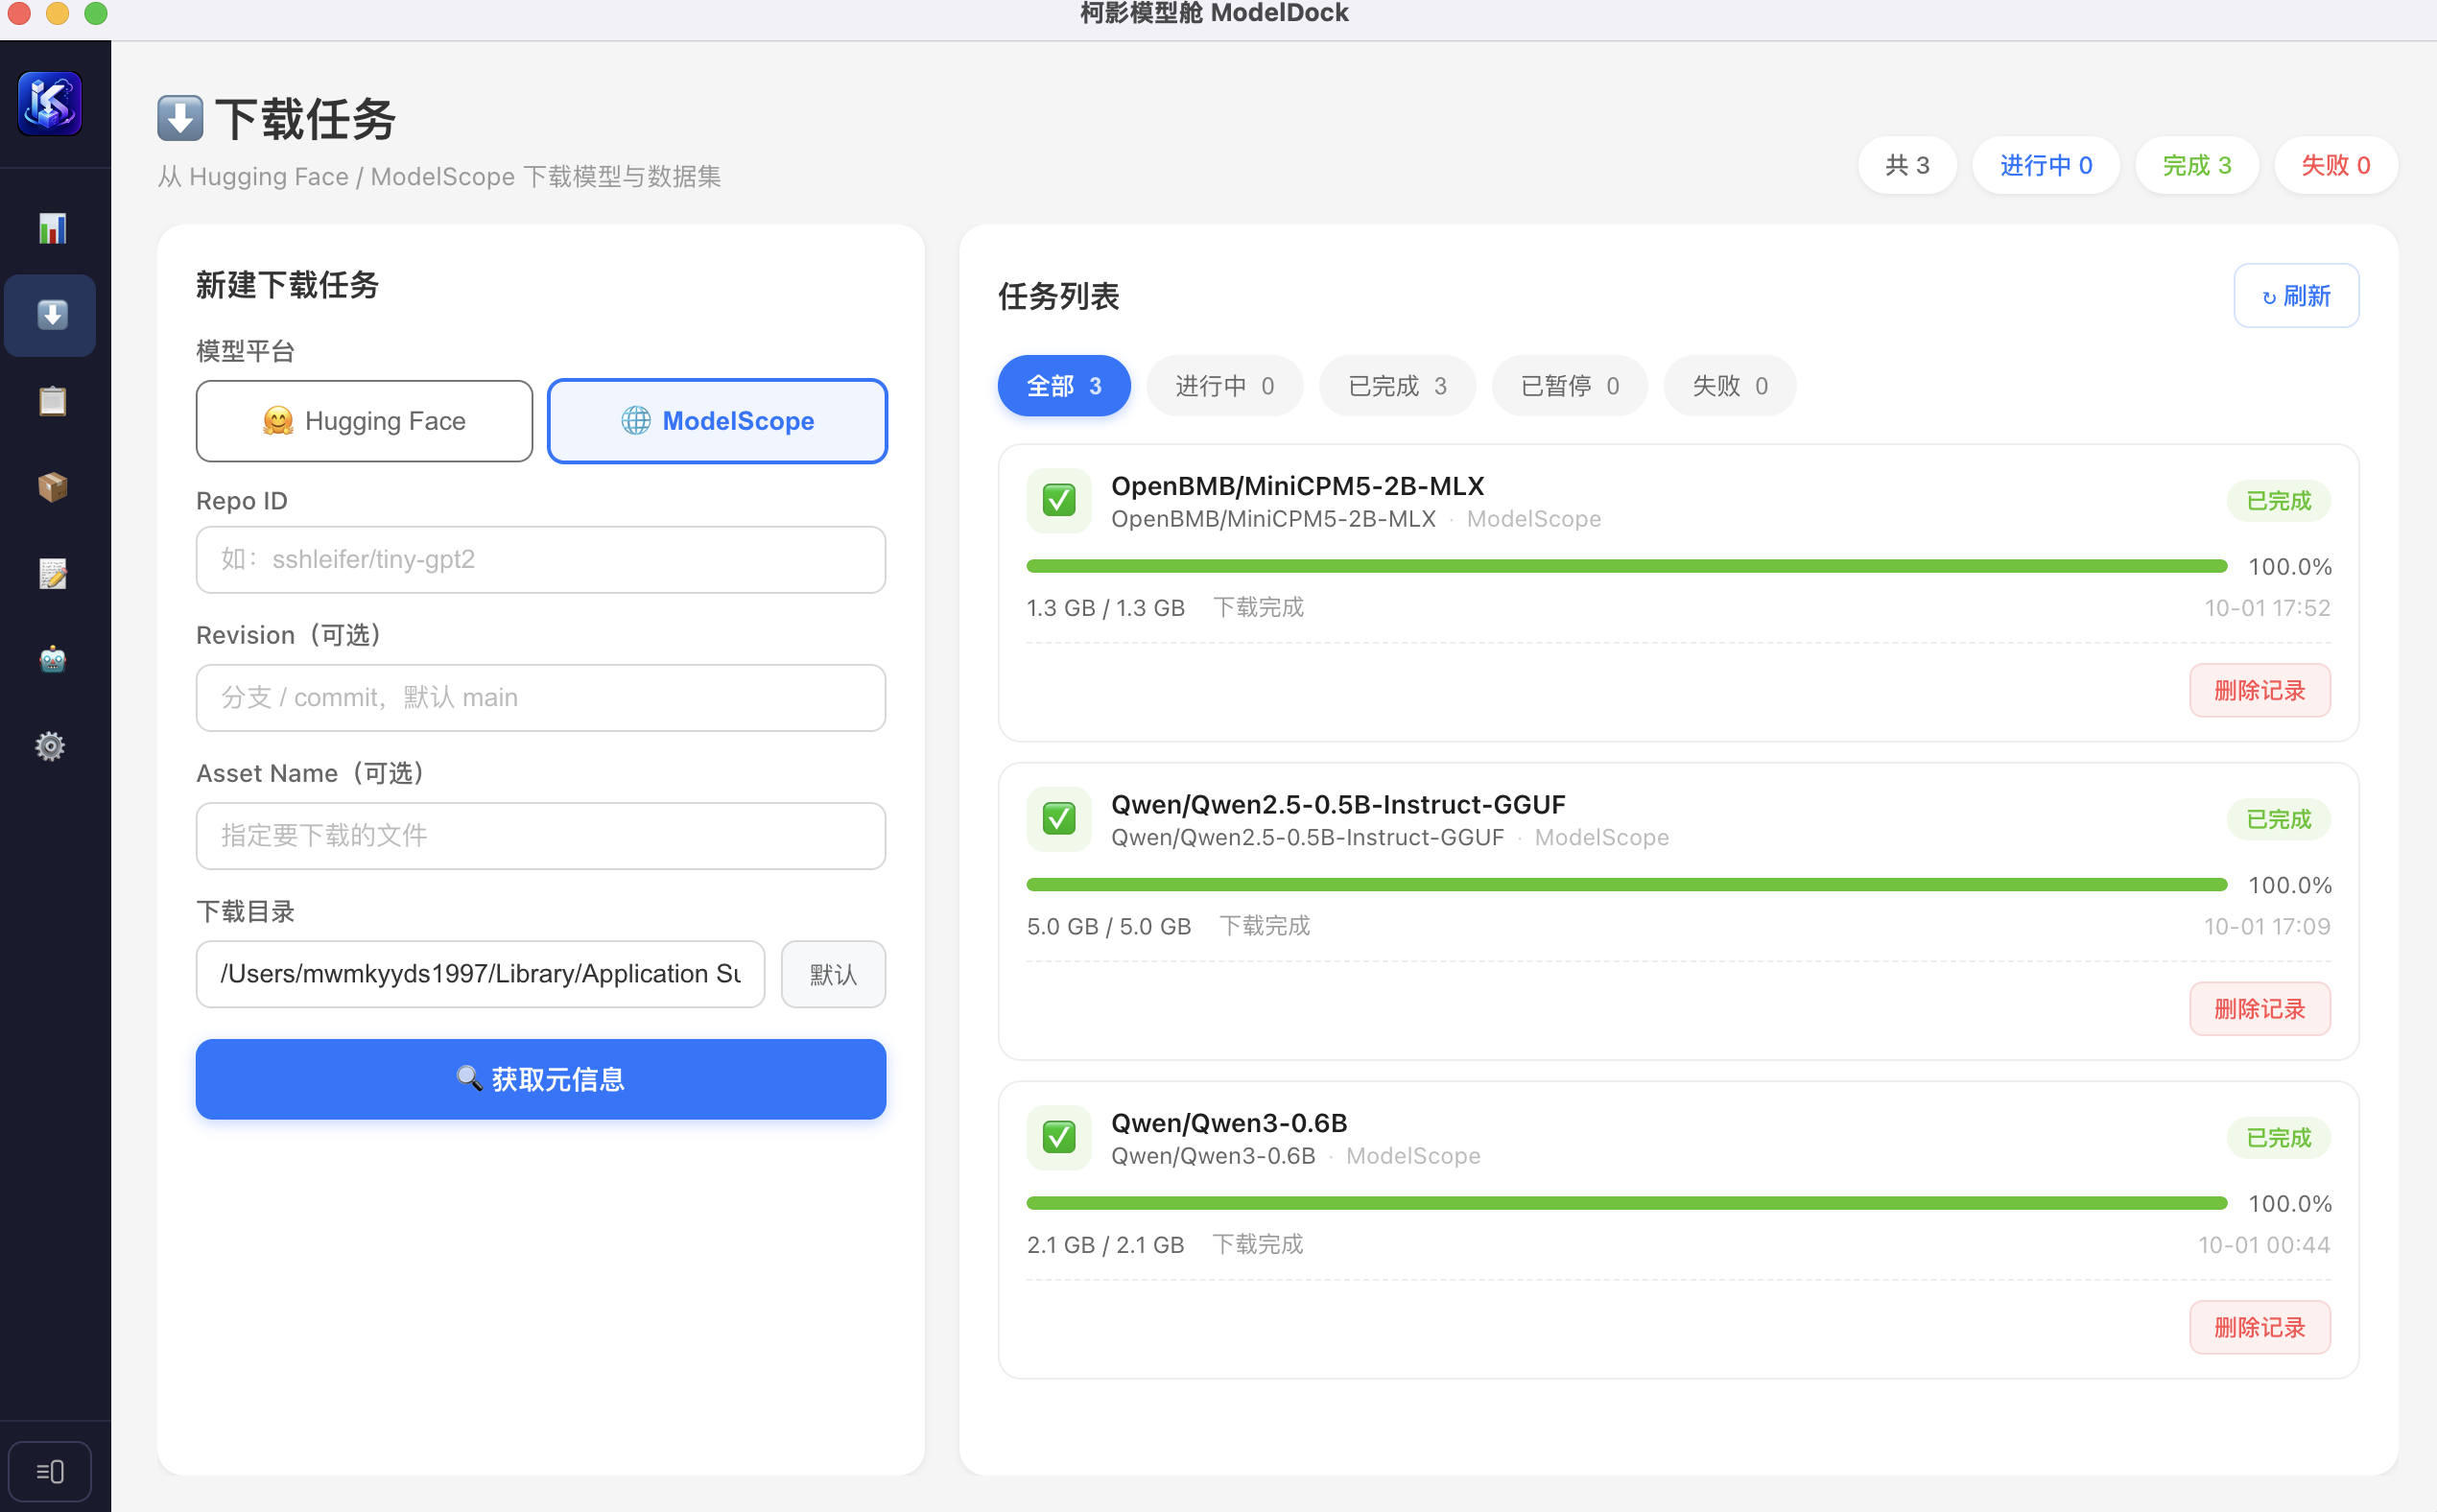
2026 年 10 月 1 日,柯影模型舱 ModelDock v0.2.1 正式发布。 这次更新不只是一次常规版本迭代,更是 ModelDock 完成架构换代后的首个正式特性版本。 从最初解决「模型怎么下载」的问题,到现在逐步覆盖模型下载、识别、管理、部署与本地推理测试,ModelDock 正在向一个更完整的本地 AI 模型工作台演进。
🚀 从 Model Downloader 到 ModelDock
v0.2.1 正式完成品牌升级: Model Downloader App → 柯影模型舱 ModelDock 与此同时,项目彻底移除了历史遗留的 Qt / PySide6 代码和旧打包链路,桌面端统一采用 Electron + React + Flask 架构。 更重要的是,llama.cpp 运行时正式内置到应用中。 过去部署 GGUF 模型,需要用户提前配置 llama-server;现在 ModelDock 会随应用携带对应平台运行时,下载模型后即可直接进入部署流程。
📦 模型部署能力继续完善
本次版本重点优化了不同模型格式的识别与部署链路。 对于 GGUF 仓库,目录中存在多个量化文件时不再直接报错,而是可以在界面中选择具体量化版本,并默认推荐常见的 q4_k_m。 对于大型 Safetensors 模型,ModelDock 现在能够识别分片权重与索引文件,并在启动前检查分片完整性,避免模型加载到一半才发现文件缺失。 MLX 模型识别逻辑也进行了调整,可以结合目录名称、张量布局和模型配置判断模型类型,减少 MLX 量化模型被错误识别为 Transformers 模型的问题。 目前 GGUF + llama.cpp 与 Safetensors + Transformers 部署链路已经完成实际验证。 MLX 部署链路目前也已经完成基础识别、运行时路由与测试,但仍存在已知 Bug,尚未达到稳定部署状态,后续版本会继续修复和完善。因此,现阶段不建议将 MLX 部署能力视为完全可用的稳定功能。
🛠 下载终于不再“一卡就是永远”
v0.2.1 集中处理了下载任务中的异常状态。 当网络或第三方下载接口出现停滞时,ModelDock 会先提示任务异常;持续停滞则由看门狗自动收敛任务状态并释放调度槽。 暂停、取消、僵尸线程、进度提前显示 100%、ETA 无限增长等问题,也在这一版本集中进行了修复。
🎨 桌面体验同步升级
新版本加入浅色、深色和跟随系统三种主题,并重新设计仪表盘,增加 KPI 卡片、下载趋势、任务状态环图和最近任务。 下载任务与模型部署页面采用独立滚动区域,设置、用户手册和关于页面也进行了统一整合。 ModelDock 开始越来越像一个真正的“模型舱”,而不只是一个模型下载器。
⚠️ 当前仍有哪些限制?
ModelDock v0.2.1 依然是一个持续迭代中的版本。 其中,MLX 部署目前仍存在 Bug,虽然模型识别、部署路由等基础链路已经建立,但实际使用中仍可能出现部署或推理异常,需要在后续版本继续修复。 此外,Windows 当前主要覆盖 CPU + CUDA llama.cpp 运行时,Vulkan / ROCm 尚未纳入本版本范围;Linux 制品也尚未完成完整实机验证。 换句话说,v0.2.1 解决了很多“能不能跑”的问题,但距离“所有模型、所有平台都稳定跑”还有不少工作。
✅ v0.2.1 做到了什么?
当前版本已完成 142 项 Python 测试、18 项 Electron 测试和 18 项前端测试。 GGUF 多量化模型选择、内置 llama.cpp 部署、Safetensors 分片模型检查与部署等核心链路已经进行了实际验证;MLX 部署链路则处于已接入、仍需继续修复 Bug的阶段。 ModelDock v0.2.1 不是终点。接下来,项目还会继续完善不同模型运行时、本地部署稳定性和跨平台推理能力,让:
下载模型 → 识别模型 → 选择运行时 → 部署 → 测试逐渐形成一条更完整、更稳定的本地模型工作流。把模型下载回来只是第一步。真正的目标,是让本地模型更容易跑起来。