

不知道本机能跑什么模型?交给这个 Skill
本地部署大模型,最让人头疼的可能不是“怎么启动”,而是启动之前的一堆选择题:
这台机器能跑多大的模型?
选 Q4 还是 Q8?上下文开多少?
Ollama、llama.cpp、vLLM 还是 SGLang?
显存理论上够,实际部署真的能跑吗?
为了解决这些问题,我们开源了一个新的 Agent Skill:
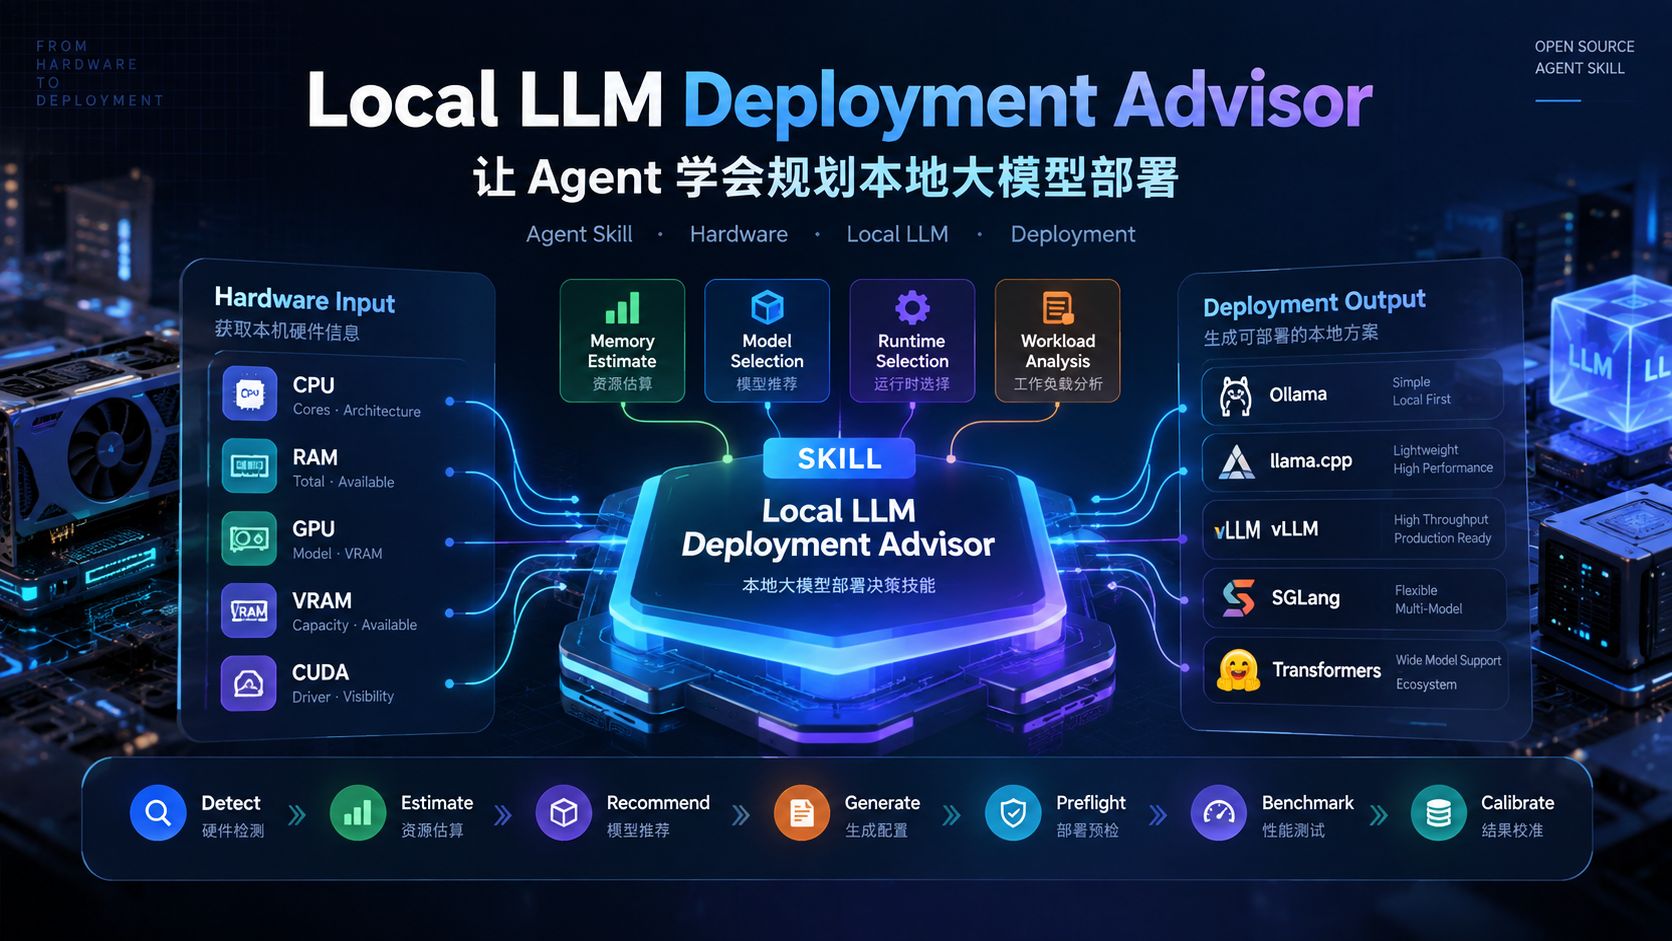
Local LLM Deployment Advisor它是一个面向本地大模型部署决策的 Skill,用于根据设备硬件、模型参数和实际工作负载,完成硬件检测、资源估算、模型推荐、部署配置生成、部署预检以及运行效果校准。
🖥️ 先让 Agent 看懂你的硬件
Skill 可以检测 CPU、内存、GPU、可用显存、NVIDIA 驱动以及 CUDA 可见性,并将硬件信息保存为后续决策依据。 这样面对“我的电脑适合部署什么模型”时,就不必只依赖一份固定的显存对照表。 先读取设备,再做判断。
🧮 模型能不能跑,不只看参数量
一个 7B 模型并不意味着只要显存达到某个数字就一定能跑。量化等级、上下文长度、KV Heads、Batch Size、并发量以及推理框架都会影响实际资源需求。 因此,这个 Skill 可以结合:
模型架构 + 参数规模 + 量化 + Context + KV Cache + Batch + 并发估算模型运行所需资源。让 Agent 的回答从:“24GB 显存应该可以。” 逐渐变成:“按照当前配置估算,可以优先考虑这个方案。”
🎯 给 Agent 一套选择模型的方法
Local LLM Deployment Advisor 不只返回一个模型,而是可以结合硬件、任务、工作负载、运行时、模型格式、许可证和平台,输出:
最低可用 / 平衡 / 高质量三档建议。这意味着模型选择不再只是“越大越好”,而是开始考虑:效果、资源与实际使用场景之间的平衡。
⚙️ 判断完,还能继续生成部署方案
这个 Skill 不止停留在“推荐”。目前已经覆盖:
Ollama / llama.cpp / vLLM / SGLang / Transformers可以继续生成 Docker Compose、环境变量模板、部署锁文件和部署报告,并考虑 GPU Device、模型缓存、健康检查等配置。从“我应该部署什么”,继续走到“我应该怎么部署”。
🔍 部署前,再做一次真实检查
理论估算只是第一层。真正部署之前,还可以检查: 可用显存、磁盘空间、端口、Docker、驱动、CUDA 和模型 Revision。 Docker GPU 实测和模型访问权限等可能产生额外操作的检查,则需要显式开启。让 Agent 不只是“生成一份看起来正确的配置”,还能够在执行之前检查环境。
📊 最后一步:让真实结果反过来修正推荐
Skill 还提供部署后的 Benchmark 与校准能力。 可以记录冷/热请求、TTFT、输出 tok/s、p50/p95、并发、错误率以及峰值显存等指标。对于 Ollama,还可以读取实际加载模型的量化、显存和上下文信息。这些真实结果能够保存到本机历史中。 下一次推荐模型时,就可以显式参考历史校准数据。于是整个 Skill 形成了一条比较完整的链路:
硬件检测 → 内存估算 → 模型推荐 → 配置生成 → 部署预检 → Benchmark → 本机校准🧩 为什么把它做成 Skill?
因为“选择什么模型”本身就是 Agent 可以参与完成的决策任务。部署工具负责把模型跑起来,而这个 Skill 更关注部署之前和之后的判断:
什么模型适合当前设备?
什么运行时更符合当前需求?
需要多少资源?
部署配置应该怎么生成?
理论估算和真实运行差了多少?
我们希望把这些原本需要人工查询、计算和反复试错的步骤,逐渐整理成 Agent 可以调用、执行和验证的标准化能力。 它不是另一个模型运行时。而是尝试给 Agent 增加一项新的能力:让 Agent 学会规划一次本地大模型部署。