

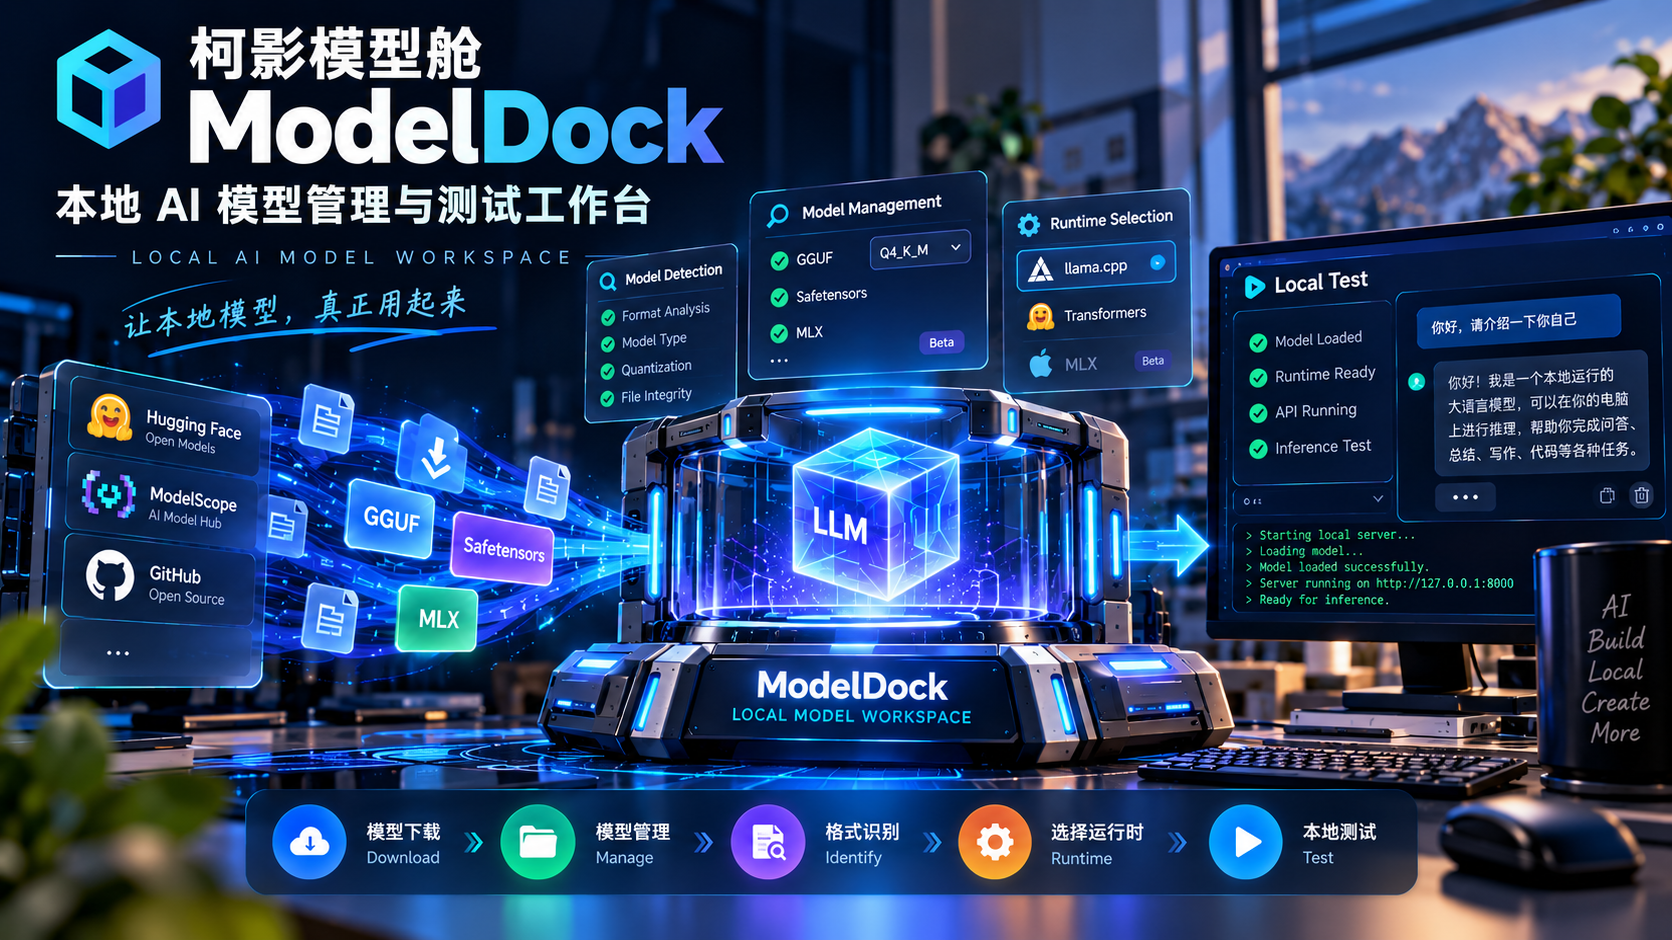
开源模型越来越多,但把一个模型下载到电脑,并不代表它已经真正“可用”。一个模型从模型平台来到本地,通常还要经历:
下载 → 文件管理 → 格式识别 → 完整性检查 → 选择运行时 → 启动 → 推理测试这也是我们开发 柯影模型舱 ModelDock 的原因。 ModelDock 是一款面向本地 AI 模型的桌面管理工具,希望把原本分散的模型下载、管理与测试操作集中到一个应用中。
模型下载
ModelDock 首先是一款模型下载与任务管理工具。 用户可以集中管理本地模型下载任务,并查看任务进度、下载速度、状态以及相关信息。 针对大模型文件下载时间长、网络环境变化明显等特点,ModelDock 加入了任务停滞检测、暂停/取消状态处理以及异常任务收敛机制。 当下载长时间没有有效数据时,系统能够识别异常状态,并在达到相应阈值后结束任务、释放调度资源。 相比“永远停在下载中”,我们更希望 ModelDock 能明确告诉用户: 这次下载失败了,可以重新处理。
本地模型管理
下载完成之后,模型会进入本地管理流程。ModelDock 不只是记录一个模型文件夹,而是尝试进一步理解模型目录中的文件结构,为后续测试提供依据。 目前主要围绕: GGUF、Safetensors、MLX 等模型形式进行识别。 不同模型格式会进入对应的检查和测试流程,从而减少完全依赖用户手动判断模型类型的操作。
GGUF 多量化版本选择
很多 GGUF 模型仓库并不只有一个模型文件。 同一个仓库可能同时提供 Q4、Q5、Q8 等多个量化版本。如果只是把整个仓库下载下来,真正运行的时候仍然需要决定:到底启动哪一个? ModelDock 支持识别仓库中的多个 GGUF 文件,并允许用户选择需要测试的具体量化版本。对于常见场景,会优先推荐 q4_k_m,同时保留其他量化版本的选择能力。这样,从下载一个 GGUF 仓库到选择具体模型进行测试,可以直接在应用中完成。
Safetensors 分片检查
大型 Transformers 模型经常采用 Safetensors 分片存储。这种情况下,即使模型目录已经存在,只要其中缺少一个分片文件,后续加载依然可能失败。ModelDock 会结合模型索引检查所需分片是否完整。 如果发现缺失,会尽可能在真正启动模型之前暴露问题,而不是等到加载过程中才发现: 模型文件没下完整。
内置 llama.cpp 测试运行时
GGUF 是 ModelDock 当前重点支持的本地模型形式之一。为了降低测试 GGUF 模型的环境门槛,ModelDock 将 llama.cpp 运行时集成到桌面应用中。因此,在对应平台上测试 GGUF 模型时,不再要求用户提前通过 Homebrew、winget 等方式单独安装 llama-server。选择模型后,即可通过应用提供的运行时启动本地服务并进行推理验证。这也是 ModelDock 从单纯的“Downloader”继续向前走的一步。
本地部署与推理测试
ModelDock 提供模型启动与本地服务测试能力,但这里的“部署”需要特别说明。当前 ModelDock 的部署定位是测试,而不是生产环境正式部署。它主要解决的是:
模型下载完成以后,能不能快速启动?
模型能不能正常加载?
运行时是否能够工作?
本地接口能否正常响应?
模型是否可以完成一次实际推理?
因此,ModelDock 更接近一个本地模型验证工作台。对于高并发推理、生产服务治理、集群调度、弹性伸缩等正式生产部署需求,目前并不是 ModelDock 的核心目标。
MLX 支持
对于 Apple Silicon 设备,ModelDock 也正在完善 MLX 模型支持。目前已经针对 MLX 模型增加识别逻辑,并建立基础运行与测试链路,减少 MLX 量化模型被错误识别并路由至 Transformers 的情况。不过,当前 MLX 部署测试仍然存在已知 Bug,尚未达到稳定可用状态。这部分能力仍在持续开发和修复中。 因此,目前更适合将 MLX 视为 ModelDock 正在建设中的模型运行路线,而不是已经完全成熟的功能。
模型任务 Dashboard
除了模型本身,ModelDock 也提供统一的桌面任务界面。Dashboard 可以展示模型与任务相关的核心数据,包括下载趋势、任务状态以及最近任务等信息。应用同时支持: 浅色 / 深色 / 跟随系统 三种主题模式,让模型管理和测试能够在一个相对完整的桌面环境中进行。
为什么叫 ModelDock?
最初,我们解决的问题其实很简单:把模型下载回来。 但随着项目继续开发,我们发现下载完成只是本地模型使用流程的开始。模型还需要被识别、检查、选择、启动和测试。 因此,原来的 Model Downloader App 逐渐演变成了今天的:柯影模型舱 ModelDock。 “Dock”代表一个模型来到本地之后的停靠点。模型可以在这里被下载、管理、识别,并通过对应的运行时进行本地测试。现阶段,我们希望先把一件事情做好: 让用户把模型下载回来以后,可以更方便地验证——它到底能不能在自己的设备上跑起来。 未来,ModelDock 还会继续完善不同模型格式、运行时以及本地推理测试体验,让本地模型的使用流程进一步连接起来:
下载 → 管理 → 识别 → 测试 → 使用下载模型只是第一步。让模型真正跑起来,才是 ModelDock 接下来持续解决的问题。