

MiniCPM-V 4.7 35B-A3B 本地部署指南:硬件选型、GGUF量化与多模态推理
随着多模态大模型不断发展,本地 AI 推理正在从传统的文本生成扩展到图像理解、文档解析、视频分析等更复杂的应用场景。但对于个人开发者而言,部署多模态模型始终面临几个问题:
模型参数量越来越大,普通设备能否运行?
MoE 架构是否真的能够降低硬件需求?
GGUF、INT4、AWQ 等量化格式应该如何选择?
Mac、Windows 和 NVIDIA GPU 应该采用什么部署方案?
如何统一管理模型下载、文件版本和推理环境?
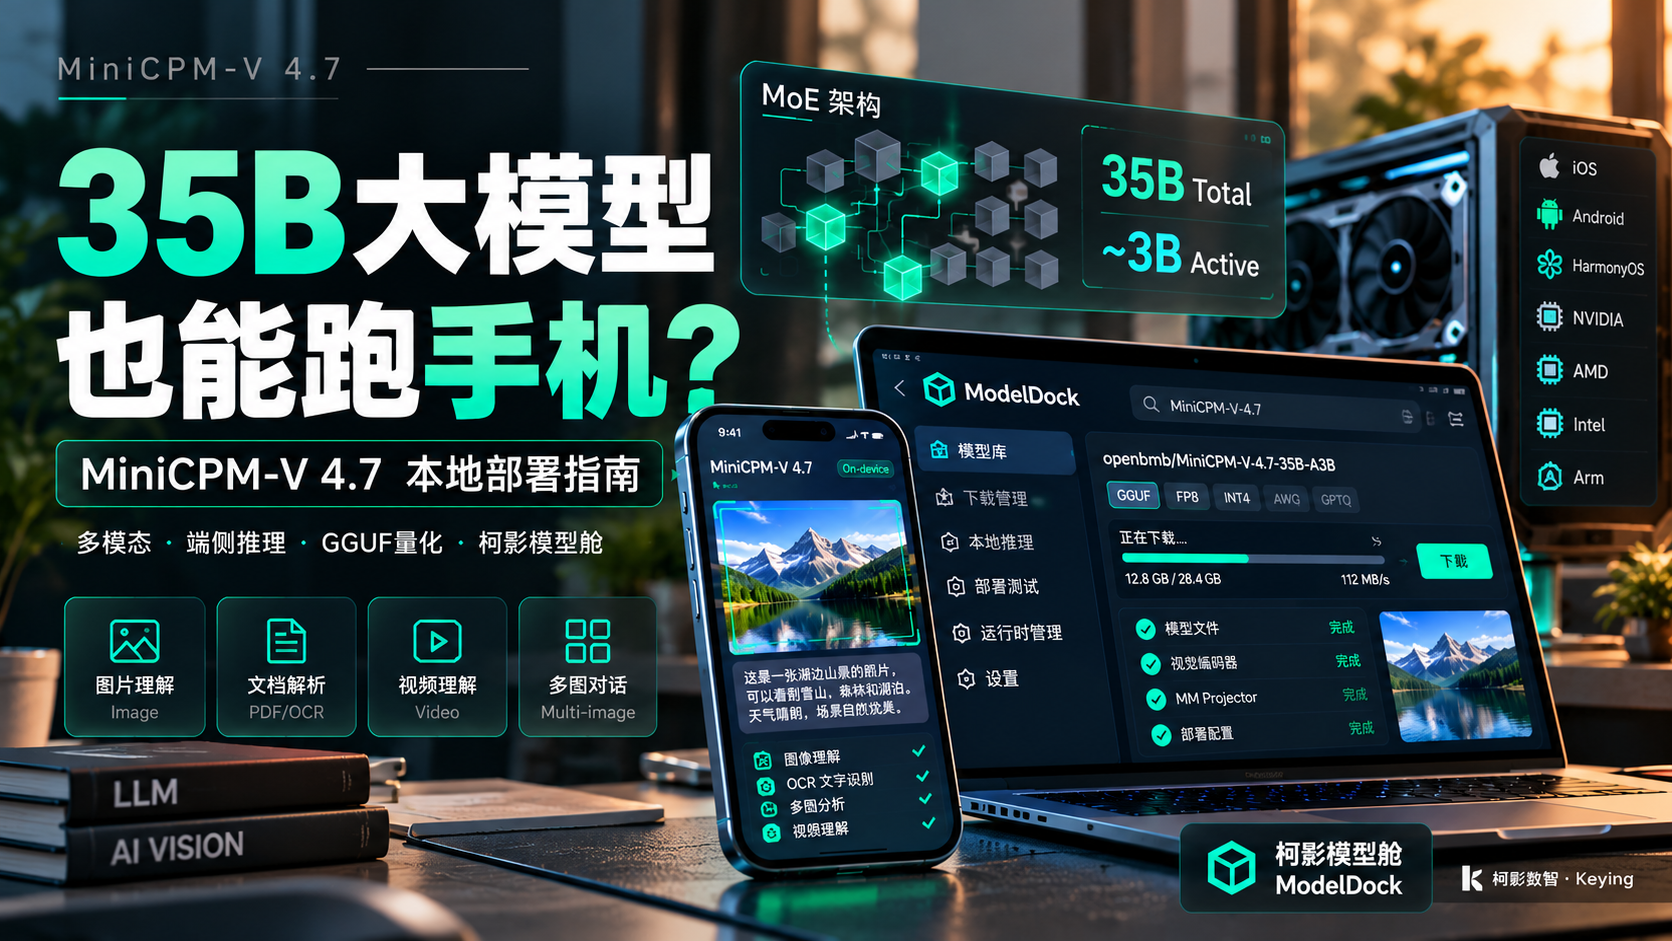
本文以 MiniCPM-V 4.7 35B-A3B 为例,介绍多模态模型的本地部署思路,并结合 柯影模型舱(ModelDock) 探索更加便捷的模型管理工作流。
01|MiniCPM-V 4.7 是什么?
MiniCPM-V 4.7 是面向多模态理解任务的大模型,采用混合专家架构(Mixture of Experts,MoE)。模型名称中的 35B-A3B 包含两个关键参数:
| 指标 | 含义 |
|---|---|
| 35B | 模型总参数量约350亿 |
| A3B | 单次推理中活跃参数量约30亿 |
| MoE | 混合专家架构 |
| 多模态 | 支持视觉信息与文本信息的联合处理 |
与传统稠密模型不同,MoE 模型通过路由机制选择部分专家参与计算,而不是每次都激活全部参数。
可以简单理解为: 一个拥有35B总参数的模型,并不意味着每次生成Token都需要使用全部35B参数进行计算。
这种设计能够降低部分计算开销,为提高推理效率创造条件。但需要注意:活跃参数量较小,不代表模型权重只占用3B参数对应的内存。实际部署时,仍然需要考虑完整模型权重、视觉编码器、KV Cache、运行时缓冲区等资源消耗。
MiniCPM-V 4.7 的主要应用方向包括:
图像理解
识别图像内容,结合自然语言完成视觉问答。
文档解析
处理包含文字、表格和图片的文档内容,适用于OCR及文档理解场景。
多图分析
结合多张图像进行信息比较与综合理解。
视频理解
针对视频帧序列开展视觉分析,具体支持方式取决于推理框架及模型实现。
这些能力使其不仅能够用于聊天,还可以进一步集成到文档处理、视觉分析和智能体系统中。
02|35B-A3B 为什么值得关注?
对于本地部署而言,MiniCPM-V 4.7 的技术价值主要体现在三个方面。
2.1 MoE 降低活跃计算量
传统 Dense 模型通常需要在每次前向计算中使用全部相关网络参数MoE 模型则通过专家路由机制,让不同输入激活不同专家。其优势在于:
减少部分推理计算开销
提升参数容量与计算成本之间的平衡
为端侧推理优化提供更多空间
不过,MoE 的实际推理效率仍然受到专家权重访问、内存带宽、硬件架构和推理引擎实现的影响。
2.2 量化降低模型存储与内存需求
量化通过降低权重表示精度,减少模型文件体积及权重占用。例如,将部分权重从16位表示转换为4位表示,可以显著减少对应权重的存储需求。但实际压缩比例并不一定等于理论比例。因为模型可能包含:
不同精度的权重
视觉编码器
量化元数据
运行时缓存
不参与量化的特殊模块
因此,选择量化模型时,不能仅根据参数量估算运行内存。
2.3 面向端侧推理的优化
MiniCPM-V 4.7 的端侧优化涉及专家调度、分层量化及推测采样等技术。相关技术包括:
| 技术 | 主要作用 |
|---|---|
| LES | 优化专家调度与权重访问 |
| 分层量化 | 根据不同网络层的特点分配量化精度 |
| DSpark | 通过推测采样机制优化生成过程 |
这些优化的目标是降低推理延迟,提高有限硬件资源下的执行效率。
不同推理框架的算子支持、内存管理和硬件加速能力可能存在明显差异。
03|本地部署需要什么硬件?
这是实际部署中最值得关注的问题。虽然 MiniCPM-V 4.7 每次推理仅激活部分专家,但完整模型仍然具有约35B总参数。因此,硬件选择应优先考虑模型权重的实际体积与可用内存。
3.1 不同硬件的部署建议
| 硬件配置 | 推荐方案 | 适用场景 |
|---|---|---|
| Mac 16GB统一内存 | 低比特GGUF探索性测试 | 验证兼容性,不保证完整加载 |
| Mac 24GB–32GB统一内存 | 低比特GGUF | 本地开发与功能验证 |
| Mac 64GB统一内存 | GGUF量化模型 | 更充足的推理空间 |
| NVIDIA 24GB显存 | INT4或混合CPU/GPU卸载 | GPU推理实验 |
| 多GPU工作站 | BF16、FP8或其他优化格式 | 高性能推理与服务部署 |
以上属于硬件选型参考,而非经过实测的最低配置要求。实际是否能够运行,取决于模型文件大小、视觉组件、量化方式、上下文长度以及推理框架的支持情况。
3.2 MacBook Air M3 16GB 能运行吗?
对于16GB统一内存的 MacBook Air,建议采取保守策略。首先确认模型是否提供兼容的低比特 GGUF 版本,再检查模型文件及视觉组件的总体积。如果模型权重已经接近或超过可用内存,即使使用 MoE 架构,也可能出现:
模型加载失败
内存压力过高
系统频繁使用交换内存
推理速度明显下降
因此,对于16GB设备,更建议将 MiniCPM-V 4.7 作为兼容性研究对象,而不是直接将其定位为日常稳定运行的模型。如果目标是持续进行多模态本地开发,24GB以上统一内存通常能够提供更大的配置空间。但具体需求仍应以实际模型文件及运行测试为准。
04|GGUF、INT4、AWQ 应该怎么选择?
部署前,需要先确定模型格式与推理框架。不同格式并非完全通用。
| 格式 | 主要特点 | 常见部署环境 |
|---|---|---|
| BF16 | 较高数值精度,资源需求较大 | PyTorch、Transformers |
| FP8 | 降低部分计算与存储开销 | 支持FP8的GPU推理框架 |
| INT4 | 低比特整数权重量化 | 特定量化推理后端 |
| AWQ | 激活感知权重量化 | 兼容AWQ的推理框架 |
| GPTQ | 基于校准的训练后量化 | 兼容GPTQ的推理框架 |
| GGUF | 面向llama.cpp生态的模型文件格式 | llama.cpp及兼容运行时 |
对于个人开发者而言,GGUF 通常是值得优先研究的部署格式之一。它的优势包括:
便于管理量化模型文件
支持多种CPU和GPU计算后端
适合构建本地推理服务
能够与 llama.cpp 生态结合
对于 MiniCPM-V 4.7 这样的多模态 MoE 模型,还需要确认:
推理引擎是否支持其模型架构。
是否支持对应视觉编码器。
是否需要额外的多模态投影文件。
当前量化文件是否与运行时兼容。
只有完成这些检查,才能进入实际部署阶段。
05|使用 llama.cpp 进行本地部署
对于 macOS 用户,可以从 llama.cpp 开始构建本地推理环境。下面以 Homebrew 安装为例。
5.1 安装 llama.cpp
首先确认 Homebrew 已安装。在终端执行:
brew install llama.cpp安装完成后,检查运行时:
llama-server --help如果能够正常输出参数说明,代表 llama.cpp 的基础环境已经准备完成。
5.2 准备模型文件
下载与当前 llama.cpp 版本兼容的 MiniCPM-V 4.7 GGUF 模型。模型目录可以采用以下结构:
models/
└── MiniCPM-V-4.7/
    ├── model.gguf
    └── mmproj.gguf
上述目录仅为结构示意。实际文件名称、分片数量以及是否需要独立的 mmproj 文件,应以模型发布仓库和推理框架说明为准。
5.3 启动本地推理服务
如果模型架构已被当前 llama.cpp 版本支持,可以尝试:
llama-server \
  -m ./models/MiniCPM-V-4.7/model.gguf \
  --host 127.0.0.1 \
  --port 8080 \
  -c 4096
参数说明:
| 参数 | 作用 |
|---|---|
| -m | 指定模型文件 |
| --host | 设置服务监听地址 |
| --port | 设置服务端口 |
| -c | 设置上下文长度 |
如果模型需要独立的视觉投影文件,则可能还需要添加:
--mmproj ./models/MiniCPM-V-4.7/mmproj.gguf注意:以上命令是通用 llama.cpp 部署示例,不是已经验证可直接运行 MiniCPM-V 4.7 的专用命令。
实际启动参数需要结合对应模型的官方部署说明调整。
5.4 测试推理接口
服务启动后,可以先检查本地接口:
curl http://127.0.0.1:8080/v1/models如果服务提供兼容的接口,可以进一步使用客户端进行测试。建议按照以下顺序验证:
第一阶段:模型加载
检查权重加载、内存占用和启动日志。
第二阶段:文本推理
验证基础文本生成能力。
第三阶段:单图理解
验证视觉编码器和图像输入链路。
第四阶段:多图及文档分析
检查更复杂的多模态输入是否得到正确处理。
第五阶段:性能测试
记录首Token延迟、生成速度、内存占用和运行稳定性。
通过逐步测试,可以区分模型加载问题、推理框架兼容问题和多模态输入处理问题。
07|如何评估本地推理性能?
模型能够成功启动,并不代表已经达到理想的运行状态。对于多模态模型,建议重点关注以下指标。
| 指标 | 说明 |
|---|---|
| 模型加载时间 | 从启动到模型可用所需的时间 |
| 首Token延迟 | 输入请求后产生首个输出Token的耗时 |
| Tokens/s | 文本生成阶段的速度 |
| 内存占用 | 推理过程中的实际内存需求 |
| 图像处理延迟 | 图像编码及视觉预处理耗时 |
| 稳定性 | 长时间运行及重复请求的可靠性 |
其中,Tokens/s 并不能完整反映多模态推理体验。例如,在图像理解任务中,模型可能需要先完成图像预处理和视觉编码,再开始文本生成。因此,即使文本生成速度较快,整体响应时间仍可能受到视觉处理阶段的影响。建议在相同硬件、相同量化版本和相同输入条件下进行对比,避免直接比较不同测试环境中的性能数字。